ブログ

  • ChatGPT Enterpriseの料金・機能と失敗しない選び方

    ChatGPT Enterpriseの料金・機能と失敗しない選び方

    ChatGPT Enterpriseは、OpenAIの法人向け「最上位」プランです。ただ、その名前の重厚さとは裏腹に、検討で最初にやるべきことは料金の問い合わせではありません。比較表を開く前に、自社側で決めるべきことが3つあります。この3つが決まれば、Enterpriseにするか、一段軽いBusiness(旧Team)にするかを絞り込みやすくなります。逆にここを飛ばして「法人導入だからEnterprise」と進めると、要件に合わない過剰投資の稟議を書くことになりかねません。

    **比較表より先に決める3つの判断軸**

    – **軸1:利用人数と契約条件** — Businessの標準ChatGPT席は==2名から==始められ、月払いと年払いの公開価格があります。一方、Enterpriseは個別見積もりで、最低席数は公式に公開されていません。現在の席数・展開計画・予算・請求条件を整理し、営業へ同じ条件で見積もりを依頼できる状態にします。
    – **軸2:ガバナンス・セキュリティ要件の厳格さ** — SCIM・Compliance API・EKM・データレジデンシー(保存地域の指定)が、自社にとって「必須要件」なのか「あれば安心」なのか。この線引きで必要なプランの段が変わります。
    – **軸3:全社共通の”汎用チャット”で足りるか** — 全社員に同じチャット画面を配れば済む業務なのか、自社の文脈を知ったうえで業務ごとに動くAIエージェントが必要なのか。後者はプランのグレード選びとは別レイヤーの投資判断です。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— AI社員「Polaris AI」の開発と、ChatGPT・Claude・Geminiを併用する自社AI社員組織(3部門・約20のAIエージェント)の運用に携わるメンバーが執筆しています。

    ## ChatGPT Enterpriseとは — OpenAI法人向けプランの全体地図

    ChatGPT Enterpriseとは、OpenAIが提供するChatGPTの法人向け最上位プランです。SAML方式のシングルサインオン(SSO)、SCIMによるユーザーの自動プロビジョニング、Compliance API、データ保持期間のカスタマイズ、データレジデンシーといった組織向けの管理・統制機能を備え、入力したデータを既定でモデルの学習に使わないことが明確化されています([OpenAI公式](https://openai.com/ja-JP/chatgpt/enterprise/))。料金は公開されておらず、==個別見積もり==です。2023年8月に[提供が始まり](https://openai.com/index/introducing-chatgpt-enterprise/)、現在はBusinessの上位に位置づけられています。押さえておきたいのは、Enterpriseの選定理由をプラン名や漠然とした安心感ではなく、**高度な統制機能と契約支援が必要か**で説明することです。
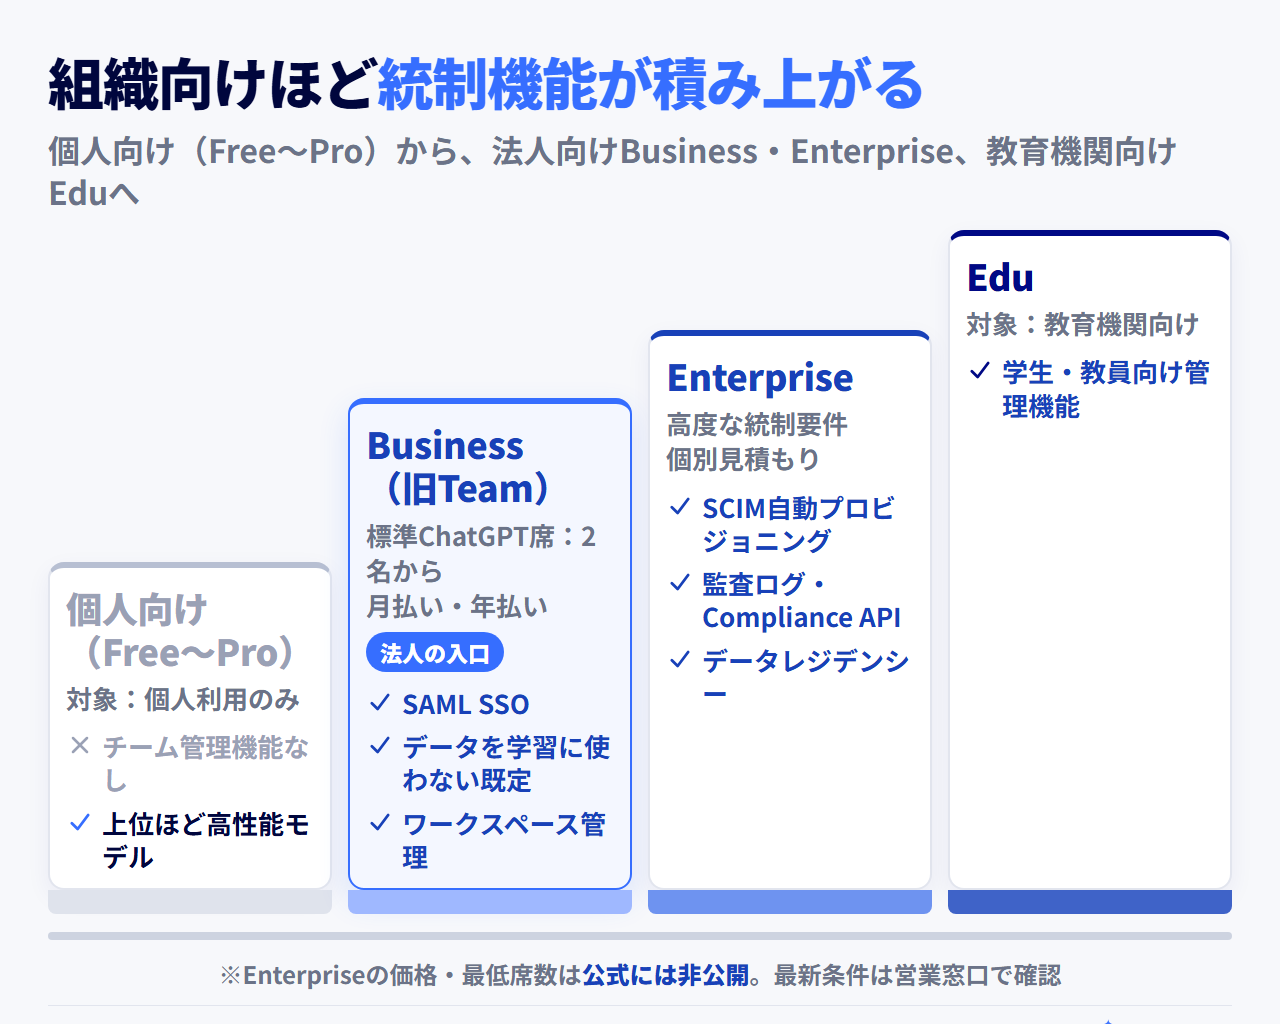
    ![ChatGPTのプラン階層を段状に示した図。個人向けのFree・Go・Plus・Proから、法人向けのBusiness(標準ChatGPT席は2名から・月払いと年払い)、Enterprise(高度な統制要件・個別見積もり)、教育機関向けのEduへと、管理機能のレベルが段階的に上がることを表している](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig1-ladder-plan-tiers.png)

    ### Free / Plus / Business(旧Team)/ Enterprise / Edu の位置づけ

    ChatGPTのプランは、大きく個人向けと組織向けに分かれます。個人向けは無料のFreeを起点に、低価格のGo、標準のPlus、上位のProという構成です。組織向けは3つあり、中小規模のチームから使えるBusiness、大規模組織向けのEnterprise、教育機関向けのEduが並びます。

    このうちBusinessは、**2025年8月29日にTeamから名称変更**されたプランです([OpenAI Help Center](https://help.openai.com/en/articles/12111915-chatgpt-business-rename-faq))。名称変更のみで、当時の機能・料金は据え置きと公式に案内されています。古い比較記事では「Team」と表記されていますが、現在のBusinessと同じものを指していると読み替えて問題ありません。「法人契約=Enterprise」ではなく、法人向けの入口はむしろBusinessであり、Enterpriseはその上の統制強化版という位置づけです。

    ### Enterprise固有の機能 — Businessとの境界線

    組織向けプランの土台となる機能は、実はBusinessの段階でかなり揃っています。公式の案内では、Businessにもワークスペース管理・SAML SSO・SOC 2準拠・入力データを既定で学習に使わない扱いが含まれるとされています([OpenAI Business Pricing](https://openai.com/business/pricing/))。Enterpriseで加わるのは、その先の統制レイヤーです。

    – **SCIMによるユーザー自動プロビジョニング** — 入退社・異動に合わせたアカウントの自動同期
    – **監査ログ・Compliance API** — 利用状況の監査・コンプライアンス対応のためのデータ取得
    – **データ保持期間のカスタマイズ/データレジデンシー** — 保持ポリシーと保存地域の統制
    – **EKM・ロールベースのアクセス制御(RBAC)・優先サポート** — 鍵管理、権限分離、SLAを含む契約・運用面の支援

    入力データを既定で学習に使わない扱いはBusinessにも共通するため、それだけではEnterpriseを選ぶ理由になりません。Enterprise固有の価値は、高度なID管理・監査・データ統制・契約支援にあります。この機能群を要件として必要とするかどうかが、後述の判断軸2です。

    ### 補足:「エージェントモード」はプラン名ではない

    なお、ChatGPTの「エージェントモード」(AIが複数ステップの作業を自律実行する機能)は、Enterpriseとは別の話です。エージェントモードは有料プランに含まれる**機能**の名前、Enterpriseは契約**プラン**の名前で、レイヤーが異なります。本記事はプラン選定に絞り、エージェント機能そのものの解説には踏み込みません。

    ## Enterpriseを検討する前に決める3つの判断軸

    Enterpriseの検討で最初に必要なのは、自社の条件を3つの軸で言語化することです。軸1は利用人数と契約条件(見積もりの前提を整理できるか)、軸2はガバナンス・セキュリティ要件の厳格さ(統制機能が必須か)、軸3は解決したい課題の種類(全社共通の汎用チャットで足りるか)。この3軸が決まっていれば、Businessとの比較や営業への問い合わせが具体的になります。特に軸1と軸2は、情報システム・法務・調達を交えて先に確認しておくべき要件です。
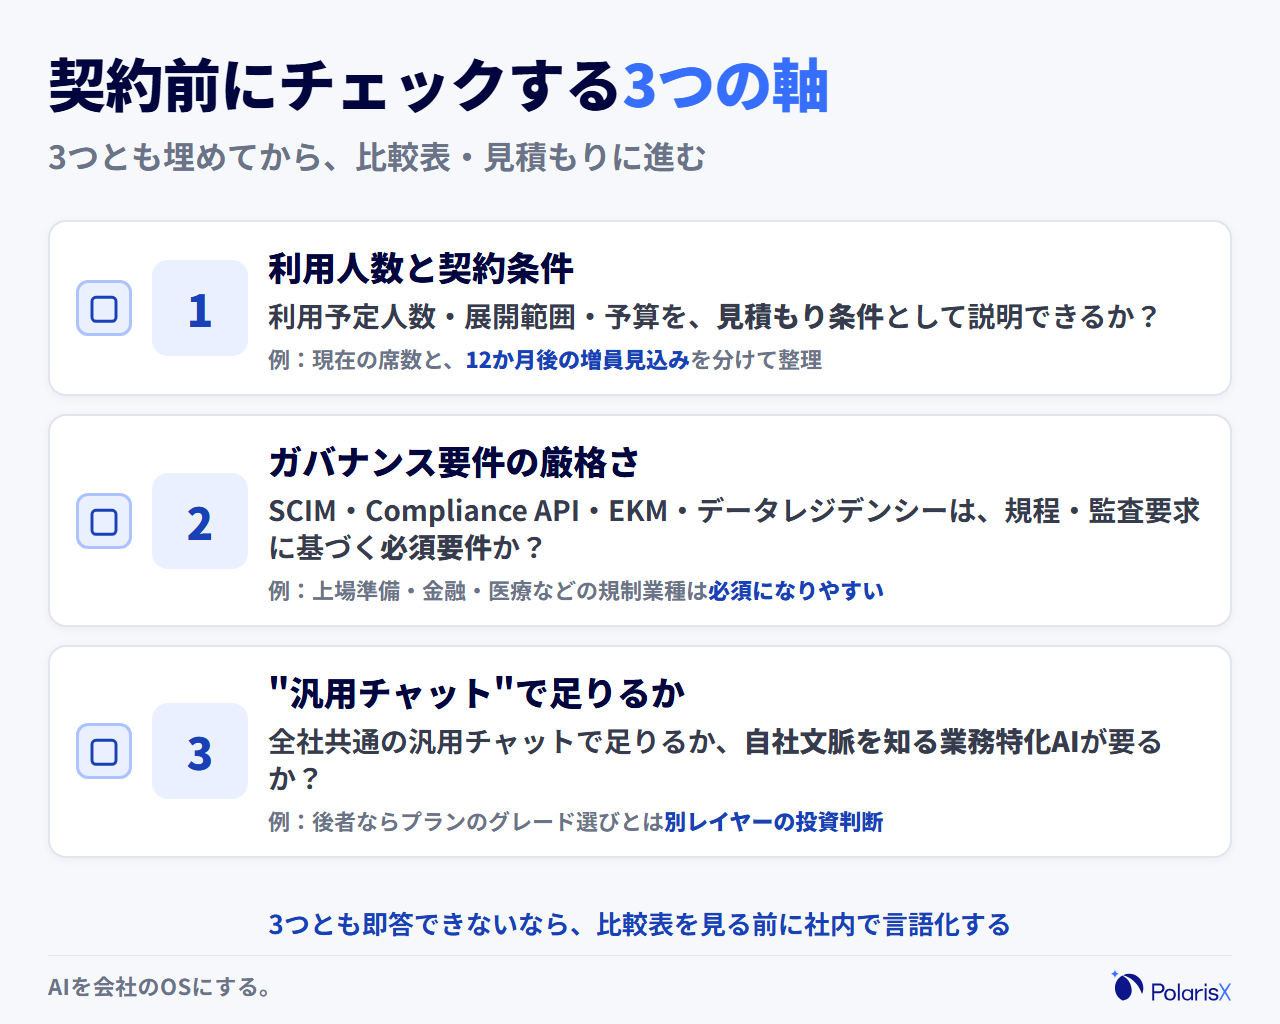
    ![ChatGPT Enterprise検討前の自己診断チェックカード。利用予定人数・展開範囲・予算を見積もり条件として説明できるか、SCIM・Compliance API・EKM・データレジデンシーは必須要件か、全社共通の汎用チャットで足りるかの3項目を、チェックボックス付きで確認できる形にした図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig2-checklist-decision-axes.png)

    ### 軸1:利用人数と契約条件を見積もりに落とせるか

    Enterpriseの最低契約席数は、公式の料金ページでは公開されていません。非公式ブログの推定席数を導入可否の基準にせず、現在の利用予定人数、12か月程度の増員見込み、部署単位か全社展開か、請求・法務・サポートの条件を整理して営業へ確認します。Businessは標準ChatGPT席を2名からオンラインで契約できるため、まずBusinessの総額を基準にし、Enterpriseで必要になる統制機能と契約支援を含めた見積もりとの差を比較するのが実務的です。

    ### 軸2:統制機能が「必須要件」か「あれば安心」か

    軸2で問うのは、SCIM・Compliance API・EKM・RBAC・データレジデンシーといった高度な統制機能が、自社にとって**要件**なのか**願望**なのかです。上場準備でIT統制の整備が必要、規制業種で監査データの取得が求められる、データの保存地域に社内規程がある——こうした場合、統制機能は必須要件であり、Enterpriseを検討する明確な理由になります。一方「セキュリティは高いほど安心だから」という理由しか出てこないなら、それは願望です。Businessの段階でもSAML SSO・SOC 2準拠・入力データを既定で学習に使わない扱いが案内されています。要件を文書化できるか(どの規程・どの監査要求に基づくか言えるか)が、実務的な見分け方です。

    ### 軸3:「全社共通の汎用チャット」で足りるか

    軸3は、プランの上下ではなく、そもそも何を導入したいのかという問いです。ChatGPTの法人プランは、どのグレードを選んでも「賢い汎用チャットを全社員に配る」施策であることに変わりありません。議事録の要約、メールの下書き、調べものの壁打ちのように、社員が自分で指示を出して使う業務にはよく効きます。一方で、「問い合わせ対応を自動で一次回答させたい」「自社の過去案件を踏まえた提案書を作らせたい」のように、==自社の文脈を知ったうえで特定業務を担わせたい==なら、それは汎用チャットの配布では実現しません。この場合に必要なのは上位プランではなく、社内ナレッジベースとの接続や業務特化のAIエージェントという別レイヤーの投資です。軸3の答えが後者なら、Enterprise/Businessの比較と並行して、その設計を検討する必要があります。

    ## 料金とBusiness(旧Team)との違いを軸ごとに比較する

    料金面の結論を先に言うと、Businessには公開価格があり、Enterpriseは個別見積もりです。2026年7月31日に確認した公式案内では、Businessの標準ChatGPT席は2名からで、1席あたり月払い25ドル、年払いでは月額20ドル相当です([OpenAI Help Center](https://help.openai.com/en/articles/8792828-what-is-chatgpt-team))。Enterpriseは価格と最低席数を公開しておらず、営業への問い合わせが必要です。両者の差は単純な人数や単価だけではなく、価格の透明性、契約・請求条件、高度な統制機能、サポートの組み合わせにあります。

    ### 価格・公開条件・契約形態の比較【2026年7月31日確認】

    | 比較軸 | Business(旧Team) | Enterprise |
    |—|—|—|
    | 料金 | 月払い1席25ドル/年払いで月20ドル相当(公式公開価格) | 個別見積もり(公式価格は非公開) |
    | 開始人数 | 標準ChatGPT席は2名から | 最低席数は公式に未公表 |
    | 契約形態 | 月払い・年払いをオンラインで選択 | 営業経由で条件を確認し、個別に契約 |
    | 予算化 | 公開価格から席数別の総額を試算しやすい | 席数に加え、請求・法務・サポート条件を含めて見積もる |
    | 向く要件 | セルフサービスで導入でき、標準的な管理機能で足りる | SCIM・Compliance API・EKM・RBAC・データレジデンシー・SLAなどが必要 |

    Enterpriseに単一の公式価格表や公開された最低席数はありません。検討時は[OpenAIの公式ページ](https://openai.com/ja-JP/chatgpt/enterprise/)から、自社の席数と契約条件をそろえて見積もりを取ってください。Businessの価格や機能も変わり得るため、契約直前に公式情報を再確認します。

    ### 機能差 — 差が出るのは「管理」の領域

    機能面の差を見るときのコツは、「使う人の体験」と「管理する人の機能」を分けることです。両プランとも業務向けのチャット、データ分析、コネクタなどを備えますが、提供モデル・利用上限・コンテキスト長は更新されるため、選定時点の料金ページで確認が必要です。継続的な差として説明しやすいのは管理者側の統制機能です。
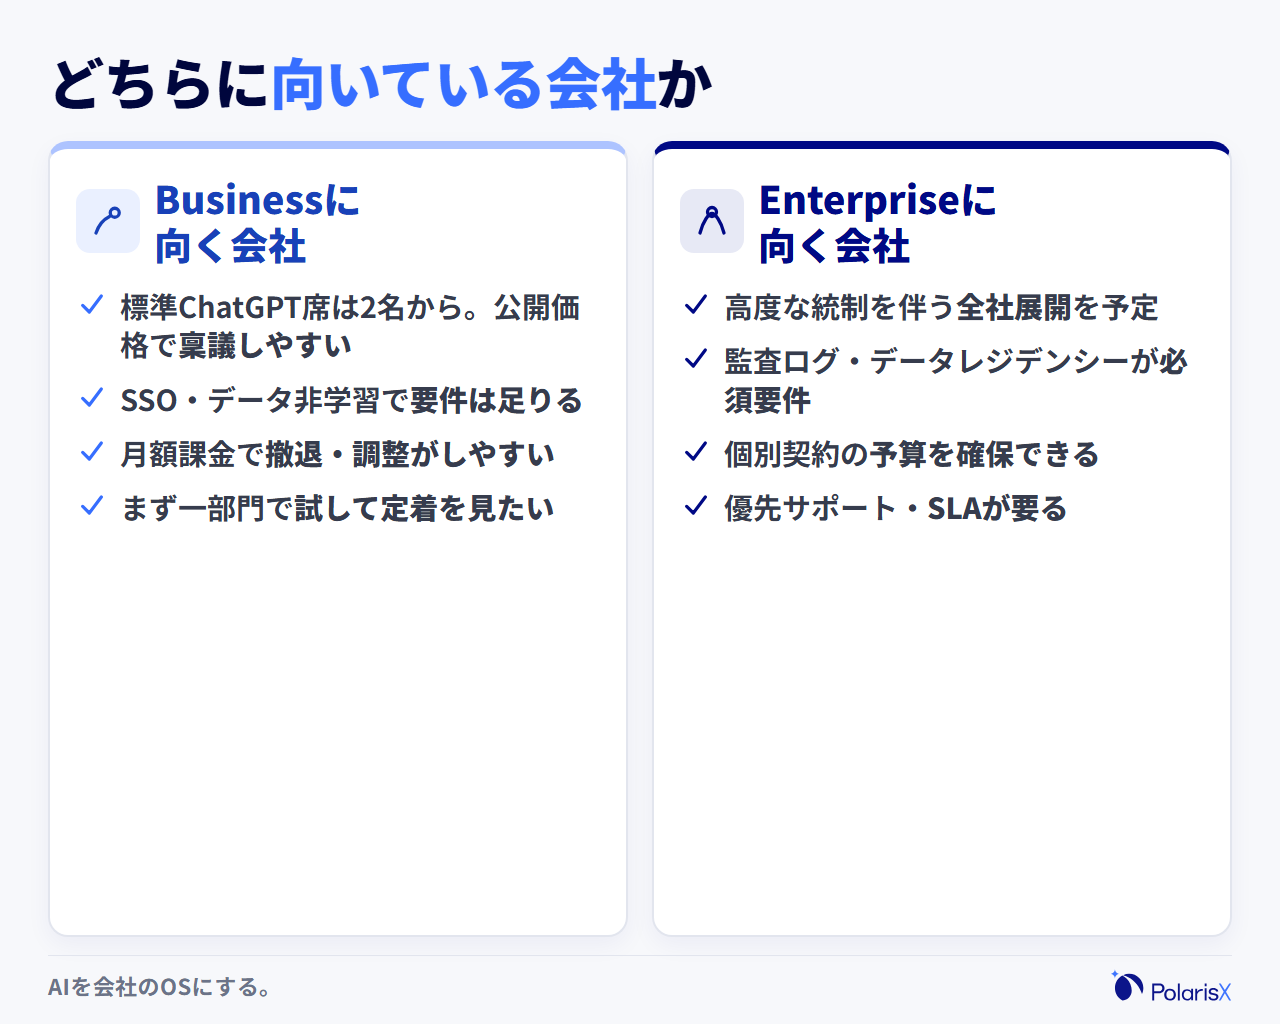
    ![Businessに向く会社とEnterpriseに向く会社を左右で対比した図。左はBusinessに向く会社で、標準ChatGPT席を2名から公開価格で始められ、SAML SSOと非学習の扱いで要件が足り、月払いで調整しやすい。右はEnterpriseに向く会社で、高度な統制を伴う全社展開、監査ログやデータレジデンシー、個別契約の予算、優先サポートが必要という特徴を並べている](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig3-contrast-business-vs-enterprise.png)

    – **Businessで足りる管理**:メンバーの追加・削除、ワークスペースの共有設定、SAML SSO、データを学習に使わない既定設定
    – **Enterpriseで加わる管理**:SCIMによる自動プロビジョニング、監査ログとCompliance API、データ保持期間のカスタマイズ、データレジデンシー、優先サポート・SLA

    価格差を推測するのではなく、Enterprise固有の統制機能と契約支援を社内規程・監査要求・運用負荷にひもづけ、Businessとの差額を見積もりで評価します。小規模でもデータレジデンシーやEKMが必須ならEnterpriseを検討する理由になり、利用者が多くてもBusinessの機能で要件を満たせるなら、まずBusinessから始める余地があります。

    ## 企業規模より「必要な統制」と契約条件で選ぶ

    利用人数は運用負荷と予算を見積もる材料ですが、OpenAIが公開するEnterpriseの採用基準ではありません。Businessの公開条件と標準的な管理機能で要件を満たせるならBusinessが第一候補になり、SCIM・Compliance API・EKM・RBAC・データレジデンシー・SLAなどが必須ならEnterpriseを見積もります。「Enterprise」という名前や従業員数だけで決めず、必要な統制と契約条件で比較することが過剰投資を避ける近道です。
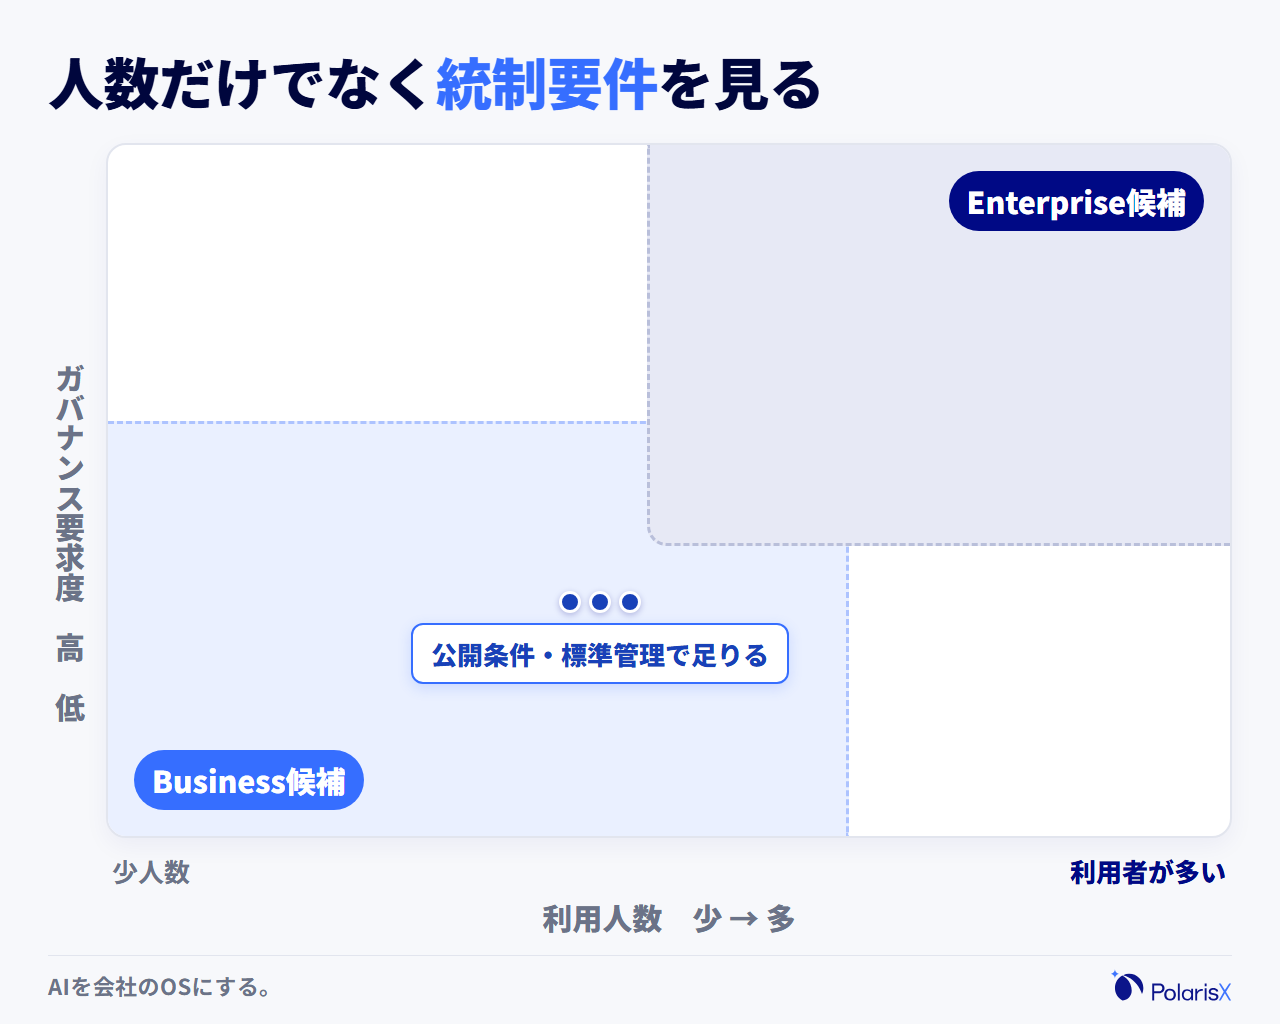
    ![横軸に利用人数、縦軸にガバナンス要求度を取ったポジショニング図。公開条件と標準管理で足りるゾーンはBusiness候補、高度な統制が必須のゾーンはEnterprise見積もり候補として示し、人数だけでなくガバナンス要件との組み合わせで選ぶことを表している](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig4-scatter-fit-plot.png)

    ### 公開価格で小さく始めたい企業:Businessが第一候補

    Businessは公開価格で予算を試算でき、標準ChatGPT席を2名から始められます。SAML SSO、ワークスペース管理、入力データを既定で学習に使わない扱いなどで社内要件を満たせるなら、まず一部の部署で開始し、利用実態を見て展開範囲を広げる進め方が取りやすいプランです。導入前に、メンバー管理の責任者、利用可能なデータ、退職・異動時の運用まで決めておくと、セルフサービスでも統制を保ちやすくなります。

    ### 高度な統制・契約要件がある企業:Enterpriseを見積もる

    次のいずれかに当てはまるなら、人数にかかわらずEnterpriseの見積もりを取る理由があります。①入退社・異動をID基盤と同期するSCIMが必要、②Compliance APIによる監査データの取得が必要、③データ保持期間・保存地域・暗号鍵・権限を細かく統制する必要がある、④SLA、優先サポート、請求や法務の個別条件が必要、という場合です。各要件を「どの規程・監査要求・運用課題に基づくか」まで書き出し、Businessでは満たせない項目を営業へ確認します。

    ## 導入して終わりにならないための見極め

    プラン選定と同じくらい重要なのに見落とされがちなのが、==どのプランを契約しても解決しない課題がある==という事実です。Enterpriseを選んでもBusinessを選んでも、導入されるのは「賢い汎用チャット」であり、①使いこなせる人だけが使う、②AIが自社の文脈を知らない、③やり取りのナレッジが個人のチャット履歴に散在する——という3つの課題はプランのグレードでは動きません。生成AIを導入した企業で「一部の社員しか使っていない」「効果が見えない」という声が繰り返し報告されるのは、ツールの性能ではなくこの構造が原因です。契約前に「この3つを誰がどう解決するか」まで設計しておくことが、導入して終わりにしないための条件です。
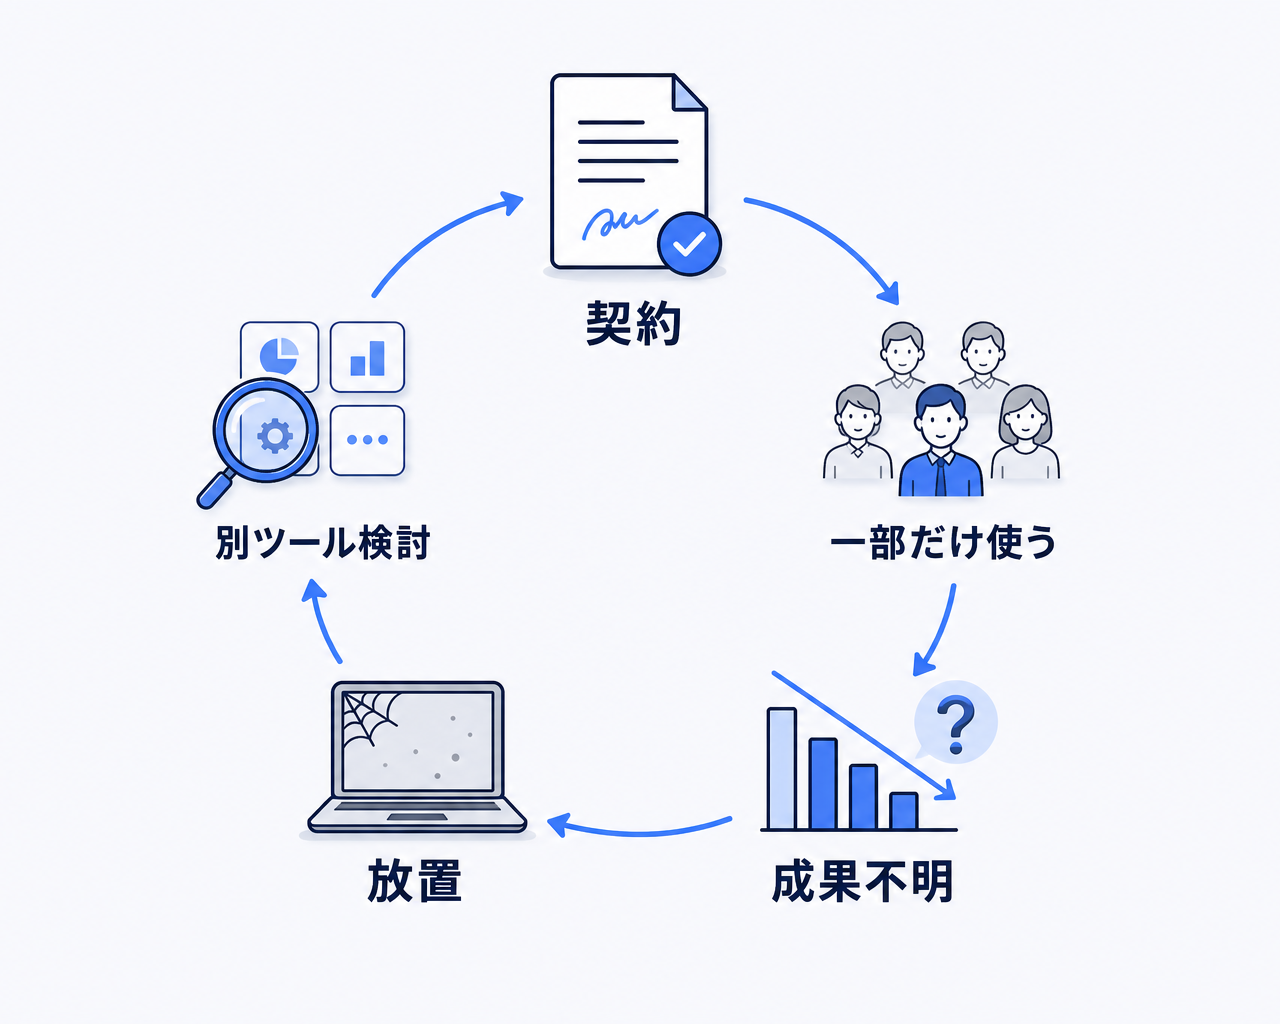
    ![汎用AIチャット導入後に起きがちな悪循環を円環で示した図。法人プランを契約し、AIに詳しい一部の社員だけが使い、全社の成果が見えず、経営が投資対効果を疑い、放置または別ツールの検討に進み、また新しい契約をするというループが、定着の設計がないまま繰り返されることを表している](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig5-loop-underuse-cycle.png)

    ### 「使いこなせる人だけ使う」問題はプランでは解決しない

    法人契約で全社員にアカウントを配っても、使われ方は自然には広がりません。プロンプトをうまく書ける社員は次々に用途を見つける一方、多くの社員は「何を聞けばいいか分からない」「期待した答えが返ってこない」で数回の試行のあと離脱します。結果として、ライセンス費用は全員分かかっているのに、価値を出しているのは一部——という状態が固定化します。これはEnterpriseの管理機能でも解決しません。監査ログで「使われていないこと」は可視化できますが、「使われるようになること」は別の施策(業務ごとの用途設計、テンプレートの整備、伴走役の設置)が必要だからです。稟議書にプラン費用だけでなく、定着施策の工数を載せているかが、この問題を直視しているかの分かれ目になります。

    ### 汎用チャットは”自社の文脈”を知らないまま

    もう一つの残存課題は文脈です。契約したChatGPTは、自社の商品も、過去の案件も、顧客との経緯も知りません。業務で使える答えを得るには、毎回その背景を人間がコピペで渡す必要があり、「それなら自分でやったほうが早い」という判断で利用が止まります。さらに、せっかく良い使い方やプロンプトが生まれても、それは==個人のチャット履歴の中に散在==し、組織の資産になりません。担当者が退職すれば、その人のAI活用ノウハウも一緒に消えます。近年は法人プランでも社内ツールとのコネクタ接続が拡充されていますが、「どの情報をどう繋ぎ、誰がメンテナンスするか」という社内ナレッジベース側の整備は、依然として自社の仕事として残ります。

    ### 現場でよく見る失敗と、私たちの見極め

    私たちPolarisXは、ChatGPT・Claude・Geminiを併用しながら、3部門・約20のAIエージェントからなるAI社員組織を自社で内製運用しています。その経験から言える見極めはシンプルで、==「契約プランの選定」と「業務に組み込むAI運用」は別レイヤーの投資判断==だ、ということです。プラン選定は「何人に・どんな統制で配るか」の問題であり、数時間の要件整理で決められます。一方、AIが実際に業務を担うようになるかは、業務の分解・自社ナレッジとの接続・出力の検証と改修という運用の積み重ねで決まります。自社のエージェントも、初期設計のまま安定稼働したものはほとんどなく、業務の実態に合わせた改修を重ねて初めて仕事を任せられる水準になりました。

    失敗のサインも明確です。**契約から3か月後、能動的に使っているのが推進担当とAIに詳しい数名だけなら、プラン選定は成功していても、導入としては失敗しています。**このときに見るべき先行指標は、週次のアクティブ利用率と、利用が特定部署・特定個人に偏っていないかの分布です。この2つを契約時から計測する前提を置いておくと、「なんとなく使われていない気がする」ではなく、数字で軌道修正の判断ができます。

    **プラン選定の先の「定着と業務組み込み」から相談したい方へ** — PolarisXは、司令塔AI社員「Polaris AI」の開発と自社AI社員組織の内製運用を行う当事者として、汎用チャットの配布で足りる範囲と、自社の文脈を知るAIエージェントが必要な範囲の切り分けからご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ## 選定フロー — 決めてから契約する

    ここまでの判断軸を、契約前にたどる分岐として並べます。上から順に答えるだけで、自社の現在地が決まります。
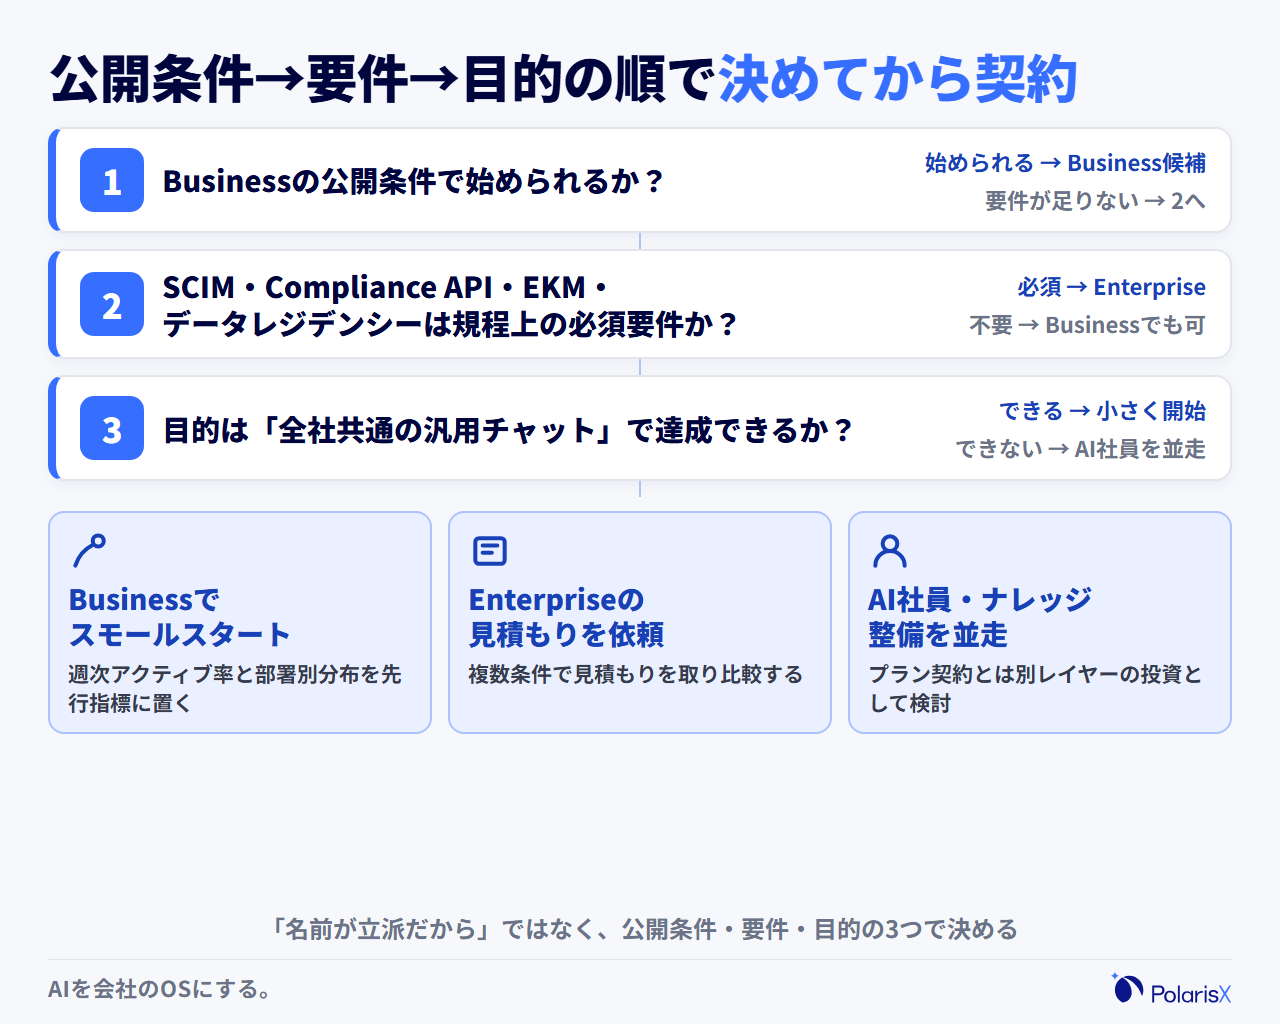
    ![ChatGPT法人プランの選定フローを示す決定木の図。Businessの公開条件で始められるか、Enterprise固有の統制機能が必須要件か、全社共通の汎用チャットで足りるかの3つの分岐を順にたどり、Businessでスモールスタート、Enterpriseの見積もり取得、プラン契約と並行してAIエージェント・AI社員の検討という3つの行き先に分かれることを表している](https://cms.polarisx.ltd/wp-content/uploads/2026/08/chatgpt-enterprise-fig6-decision-selection-flow.png)

    1. **Businessの公開条件で始められるか?** — 標準ChatGPT席は2名からで、公開価格から総額を試算できます。機能・請求・法務の条件を満たすならBusinessを第一候補にし、足りない要件があるなら2へ進みます。
    2. **SCIM・Compliance API・EKM・データレジデンシーは、規程・監査要求に基づく「必須要件」か?** — 必須なら、OpenAIにEnterpriseの見積もりを依頼します(価格は個別交渉のため、複数条件で見積もりを取り比較する)。必須でないなら、規模が大きくてもまずBusinessで始める選択肢が残ります。
    3. **導入の目的は「全社共通の汎用チャット」で達成できるか?** — できるなら、選んだプランで小さく開始し、週次アクティブ率と部署別の利用分布を定着の先行指標として置きます。できない——自社の文脈を知って特定業務を担うAIが必要——なら、プラン契約とは別レイヤーで、社内ナレッジベースの整備とAIエージェント(AI社員)の検討を並走させます。
    4. **契約直前の再確認** — Businessの公開価格とEnterpriseの見積もり条件はいずれも変わり得ます。契約前に必ず[公式の料金ページ](https://openai.com/business/pricing/)と営業提示の契約条件を確認してください。

    「名前が立派だから」でも「安いから」でもなく、利用計画・要件・目的の3つを決めてから契約する。そうすれば、ChatGPT法人導入の入口で比較すべき条件が明確になります。

    ## よくある質問

    **Q. ChatGPT Enterpriseとは何ですか?**
    OpenAIが提供するChatGPTの法人向け最上位プランです。SAML SSO・SCIMによるユーザー管理・監査ログ・データレジデンシーなど大規模組織向けの統制機能を備え、入力データをモデルの学習に使わない扱いが企業向けの前提として明確化されています。料金は公開されておらず、個別見積もりです。

    **Q. ChatGPT EnterpriseとBusiness(旧Team)は何が違いますか?**
    管理者向け機能と契約モデルに差があります。Businessの標準ChatGPT席は、公開価格(1席月払い25ドル・年払いで月20ドル相当)で2名から始められます。Enterpriseは個別見積もりで、SCIM・Compliance API・データ保持カスタマイズ・EKM・RBAC・優先サポートなどの統制・契約機能が加わります。なおTeamは2025年8月29日にBusinessへ名称変更された同一プランです。

    **Q. ChatGPT Enterpriseの料金はいくらですか?**
    公式価格は非公開で、個別見積もりです。利用予定人数、展開時期、必要な統制機能、請求・法務・サポート条件をそろえ、OpenAIの営業窓口へ確認してください。非公式サイトの推定単価は契約条件を再現できないため、予算の確定値には使わないのが安全です。

    **Q. ChatGPT Enterpriseは何人から契約できますか?**
    公式の料金ページでは、Enterpriseの最低席数は公開されていません。Businessの標準ChatGPT席は2名から始められます。Enterpriseを検討する場合は、現在の利用予定人数と増員計画を伝え、契約可能な席数と条件を営業へ確認してください。

    **Q. 中小企業でもChatGPT Enterpriseは必要ですか?**
    企業規模だけでは決まりません。Businessの段階でもSAML SSO、ワークスペース管理、入力データを既定で学習に使わない扱いが提供されます。一方、SCIM、Compliance API、データレジデンシー、EKM、RBAC、SLAなどが規程・監査・契約上の必須要件なら、小規模な組織でもEnterpriseを見積もる理由があります。

    **Q. ChatGPT Enterpriseは入力データをAIの学習に使いますか?セキュリティは安全ですか?**
    OpenAIは、Enterpriseを含む法人向けプランでは入力データを既定でモデルの学習に使わないと公式に説明しています。法人向けサービスはSOC 2に準拠し、Enterpriseではさらに監査ログ、データ保持期間のカスタマイズ、データレジデンシーなどの統制機能が提供されます。ただし「学習に使われない」ことと「自社の情報管理ルールに適合する」ことは別問題なので、社内規程との突き合わせは契約前に行ってください。

    **ChatGPTの法人導入を「契約して終わり」にしたくない方へ** — PolarisXは、①法人向けAIエージェントの開発 ②社内ナレッジベースの構築 ③AIコンサルティングサービスを提供する会社です。自社でもChatGPT・Claude・Geminiを併用し、3部門・約20のAIエージェントを内製運用する当事者として、プラン選定のその先——自社の文脈を知るAI社員の設計と定着——をご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧ください。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。ChatGPT・Claude・Geminiを日々の業務で併用する立場から、本記事は教科書的なプラン比較に、過剰投資を避ける判断軸と契約後の定着まで見据えた実務の視点を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [ChatGPT Enterprise(OpenAI公式)](https://openai.com/ja-JP/chatgpt/enterprise/)
    – [Introducing ChatGPT Enterprise(OpenAI、2023年)](https://openai.com/index/introducing-chatgpt-enterprise/)
    – [Business Pricing(OpenAI公式)](https://openai.com/business/pricing/)
    – [What is ChatGPT Business?(OpenAI Help Center)](https://help.openai.com/en/articles/8792828-what-is-chatgpt-team)
    – [Business data privacy, security, and compliance(OpenAI公式)](https://openai.com/business-data/)
    – [ChatGPT Business Rename FAQ(OpenAI Help Center)](https://help.openai.com/en/articles/12111915-chatgpt-business-rename-faq)
  • Geminiでマニュアル作成する手順|動画からの自動生成のコツ

    Geminiでマニュアル作成する手順|動画からの自動生成のコツ

    「Geminiでマニュアルを作成する」と一口に言っても、指している作業は大きく2つに分かれます。1つは、ベテランの頭の中や画面録画にしか残っていない業務を、ゼロからマニュアルの形にする作業。もう1つは、既存のWordやPDFのマニュアルを整形・要約・書き直しする作業です。この記事が主に扱うのは前者、つまり「属人化した業務を初めてマニュアル化する」場面です。どちらの作業かで準備するものもプロンプトも変わるため、着手前にここを確認してください。

    **手順の全体像は「素材準備 → Geminiへの指示 → 構成・図解の整え → 人によるレビュー → 格納・運用」の5段です。** 着手から初版完成までの目安は==最短半日〜1日==。難所は「指示が曖昧で精度が出ない」(STEP2)と「レビューなしで配布してしまう」(STEP4〜5)の2つで、逆にここさえ押さえれば大きくは失敗しません。

    – **この手順が向く場合**: 動画・画面録画・口頭説明・古い資料など、AIに渡せる”素材”がすでにある
    – **向かない場合**: そもそも業務のやり方が人によってバラバラで、何が正しい手順か決まっていない(先に標準化が必要)

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用に携わるメンバーが執筆しています。

    ## この手順が効くのはどんな場合か(前提条件)

    Geminiでのマニュアル作成が効くのは、「業務のやり方は固まっているが、文書になっていない」場合です。判断の分かれ目は==素材があるかどうか==。操作の画面録画、研修動画、ベテランの口頭説明のメモ、実態と合わなくなった古いマニュアルなど、AIに渡せる材料が何かしらあれば、Geminiはそれを構造化された手順書のドラフトに変換できます。逆に、やり方そのものが定まっていない業務では、AIは「何を正とするか」を決められません。その場合に必要なのはマニュアル作成ツールの導入より先に、関係者で標準の手順を1つに決めることです。

    ![Geminiでのマニュアル作成が自社の状況に効くかを判定するYes-No決定木。業務のやり方が固まっているか、動画・録画・口頭説明などの素材があるかの2つの分岐で、「この手順で進められる」「先に素材を集める」「先に業務の標準化が必要」の3つの行き先に分かれることを示す図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig1-decision-applicability.png)

    ### 向いているケース

    – 操作の画面録画や研修動画が残っている(またはこれから録画できる)
    – ベテランが口頭でなら説明できる(録音や箇条書きメモの形にできる)
    – 既存マニュアルが古くなり、実態に合わせて書き直したい
    – スクリーンショットや作業写真は撮ってあるが、文章化されていない

    共通するのは「知識は存在するが、文書化の工数が取れない」状態です。Geminiが肩代わりするのは、まさにこの”ゼロから書き起こす工数”の部分です。

    ### 向かないケース(先に標準化が必要)

    – 同じ業務でも担当者によってやり方が違い、どれを正とするか決まっていない
    – 例外対応が多く、そもそも「標準の手順」と呼べるものが存在しない
    – 判断の基準が言語化されておらず、動画にも映らない(商談の駆け引きなど、暗黙知の比重が大きい業務)

    この状態でGeminiに素材を投げても、「もっともらしいが、誰のやり方とも一致しない」ドラフトが返ってくるだけです。まず関係者で正のやり方を1つ決め、その手順を素材(録画やメモ)に落としてから着手してください。なお、この前提条件はGeminiに限らずChatGPTなど他の生成AIでも同じです(生成AI全般でのマニュアル作成の比較は、本記事では扱いません)。

    ## 準備するもの

    Geminiでマニュアルを作るために準備するものは4つです。(1) Googleアカウント(個人の無料版でも作成自体は可能)、(2) 使うモデルの選択(精度を求める作業では上位モデルを推奨)、(3) 素材(動画・画像・既存資料など)、(4) 法人利用の場合はGoogle Workspace上の利用権限と、機密情報の取り扱いルールの確認。専用ツールの購入は不要で、Google Workspaceを利用している会社であれば、2025年1月以降GeminiのAI機能がアドオンなしでプランに含まれるようになったと[Googleが発表しています](https://workspace.google.com/blog/product-announcements/empowering-businesses-with-AI)。

    ![Geminiでマニュアル作成を始める前に揃える4つの準備物のチェックリストカード。Googleアカウント、モデルの選択、動画・画像・既存資料などの素材、法人利用時のGoogle Workspace権限と機密情報ルールの確認を並べた図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig2-checklist-preparation.png)

    – **Googleアカウント**: 個人の無料版Geminiでも、ファイルを読み込ませてマニュアルのドラフトを作れます。ただし後述のとおり、アップロードできる動画の長さなどに制限があります。
    – **モデルの選択**: Geminiは複数のモデルを切り替えられます。長い動画や複雑な資料を読ませる場合は、精度重視の上位モデルを選ぶのが無難です。
    – **素材**: 画面録画・作業動画・写真・スクリーンショット・古いマニュアル・チャットの説明ログなど。次のSTEP1で集め方を説明します。
    – **法人利用の権限とルール**: 業務情報を扱う以上、会社として管理された環境(Google Workspace等)で使うか、少なくとも「何をアップロードしてよいか」の社内ルールを先に確認してください。個人アカウントに顧客情報入りの録画を上げてしまう、という事故が最も避けたいパターンです。

    なお、GeminiにはChatGPTのGPTsに相当する「Gem」(カスタムAI)があり、マニュアル作成用の指示をあらかじめ仕込んだ自分専用のGemを作っておくと、2回目以降の作成が速くなります。

    ちなみに私たちPolarisXは、GeminiだけでなくChatGPT・Claudeも含めて用途で使い分ける前提でAI活用を設計しています。マニュアル作成のように「動画を読ませる」「Google Workspaceの中で完結させる」場面はGeminiの得意領域、という位置づけです。

    ▶ 関連記事: [AI社員とは?意味・違い・費用と中小企業の導入判断を解説](/blogs/ai-employee)

    ## Geminiでマニュアルを作る手順

    手順は「素材を集める → Geminiに読み込ませて指示を出す → Canvasやチャットで構成・図解を整える → 人がレビューする → 格納して更新の仕組みを作る」の5段です。操作そのものはどのステップも難しくなく、Geminiが実際に文章を書いている時間は数分に過ぎません。時間を食うのは前後の工程、つまり素材を用意するSTEP1と、内容を検証するSTEP4です。1タスク分のマニュアルなら、素材が手元にある状態から初版完成まで半日程度を見ておけば足ります。差がつくのは操作の巧拙ではなく、各ステップの”つまずき所”を知っているかどうかなので、以下では操作とつまずき所をセットで説明します。

    ![Geminiでマニュアルを作る5段の手順を示すステップフロー図。素材準備、Geminiへの指示出し、Canvasでの構成・図解の整え、人によるレビュー、ナレッジベースへの格納と更新運用の順に進み、各ステップに代表的なつまずき所が注記されている](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig3-steps-manual-creation.png)

    ### STEP1 素材を集める(動画・画面録画・写真・既存資料)

    最初に、マニュアル化したい業務の素材を集めます。PC操作の業務なら画面録画が最も効率的です。Windowsでは標準機能(Snipping ToolやXbox Game Bar)で画面録画ができると多くの解説で紹介されており、追加ソフトなしで始められます。現場作業なら作業中のスマホ動画や写真、事務手続きなら古いマニュアルや申請書の実物も素材になります。

    集めた素材はGeminiにアップロードします。[Googleの公式ヘルプ](https://support.google.com/gemini/answer/14903178?hl=ja)では執筆時点で、==動画は1ファイル最大2GB・長さは合計5分まで==(Google AI Pro / Ultraでは合計1時間まで)、1つのプロンプトに追加できるファイルは最大10個まで、と案内されています。無料版で長い業務を扱う場合は、動画を工程ごとに分割するのが現実的です。

    **つまずき所: 録画が長すぎて要点が埋もれる。** 30分の作業をそのまま1本で録ると、Geminiの出力も焦点のぼやけたものになりがちです。私たちが実務で使う目安は「1動画=1タスク」。「請求書を発行する」「在庫を登録する」のような、1つの完了状態があるタスク単位で録画を区切ると、出力の精度も後の更新のしやすさも大きく変わります。

    ### STEP2 Geminiに読み込ませて指示を出す(プロンプトのコツ)

    素材をアップロードしたら、プロンプト(指示文)を添えます。精度を分けるのは==対象読者・目的・フォーマット==の3点を明記することです。SERPで上位に並ぶ解説記事でも、対象読者の情報をプロンプトに含めると精度が高まると繰り返し指摘されています。たとえば次のような形です。

    “`text
    あなたは業務マニュアルの編集者です。
    添付の動画は、経理担当が月次の請求書発行を行う画面録画です。
    次の条件で操作マニュアルのドラフトを作ってください。

    – 対象読者: 入社1か月目の新人(この業務の経験なし)
    – 目的: 動画を見返さなくても、一人で請求書発行を完了できること
    – フォーマット: 手順は番号付きリスト。各手順に「操作」
    「画面で確認するポイント」「注意点」の3項目を立てる
    – 社内用語・システム名には、初出で1行の説明を付ける
    “`

    **つまずき所: 「この動画からマニュアルを作って」だけの曖昧な指示。** マニュアル作成ツールを提供するTeachme Bizの解説でも、[Geminiは曖昧な指示では期待する出力になりにくく、明確な指示が必要](https://biz.teachme.jp/blog/gemini/)と指摘されています。また、1回の生成で完成を求めないことも重要です。「手順3と4の間に承認フローが抜けている」「専門用語が多すぎる」と対話で追加情報を渡しながら、2〜3往復でドラフトを仕上げる想定でいてください。

    ### STEP3 Canvasやチャットで構成・図解を整える

    ドラフトができたら、構成と見た目を整えます。GeminiのCanvasは、チャット欄の横に文書の作業スペースを開き、その場で編集・書き換えを指示できる機能です。[Google公式ヘルプ](https://support.google.com/gemini/answer/16047321?hl=ja)では、Canvasでドキュメントのほかウェブページやクイズ、音声解説などのコンテンツを作成できると案内されており、長い文章の図解化や、マニュアルからの理解度クイズ作成といった応用も紹介されています。Google Workspace環境なら、仕上げはGoogleドキュメントに移し、[ドキュメント内のGemini機能](https://support.google.com/docs/answer/14206696?hl=ja)で文章の調整を続けることもできます。

    **つまずき所: 動画の”その場面だけ”を切り出す作業は苦手。** 前出のTeachme Bizの解説では、動画の特定の場面をピンポイントに切り取るような使い方はGeminiが苦手とする点として挙げられています。手順書に差し込む画面キャプチャは、AIに任せるより人がスクリーンショットを撮って貼るほうが早い、というのが現実的な分担です。

    ### STEP4 内容の正確性を人がレビューする

    ドラフトの見た目が整っても、そのまま配布してはいけません。数値・専門的な手順・社内ルール・権限まわりは、生成AIが誤りをもっともらしく書いてしまう典型箇所です。その業務の経験者が事実確認を行い、誤りは修正指示としてGeminiに戻します。

    **つまずき所: 一度の生成結果で満足してしまう。** 私たちの自社運用では、コンテンツやナレッジ文書を作るとき「書く担当」と「検証する担当」を必ず分けています(AIエージェント同士でも執筆役と編集役を分けています)。マニュアルも同じで、レビューは可能なら2人(業務を知る人による正確性の確認と、知らない人による分かりやすさの確認)で行うのが理想です。正確さと分かりやすさは別の欠陥として現れるためです。

    ### STEP5 完成したマニュアルを格納し、更新の仕組みを作る

    完成したマニュアルは、置き場所を1か所に決めて格納します。Googleドライブでも社内Wikiでもナレッジ管理ツールでも構いませんが、「最新版がどこにあるか」が全員に自明であることが条件です。あわせて、更新の責任者と更新のトリガー(画面が変わったら・手順が変わったら・四半期ごとの見直し、など)を決めます。

    **つまずき所: 作って終わりで、更新されず形骸化する。** マニュアルが使われなくなる原因の多くは、出来の悪さより「実態とズレたまま放置されること」です。STEP1で「1動画=1タスク」に区切っておくと、手順が変わったときにその動画だけ録り直してGeminiに再生成させればよく、更新のハードルが大きく下がります。

    ▶ 関連記事: [ナレッジマネジメントツール比較|種類・選び方とAI活用の軸](/blogs/knowledge-management-tools)

    ## できたかどうかの判定法

    マニュアルが完成したかどうかは、見た目ではなく「新人役テスト」で判定します。方法は単純で、対象読者に近い人(その業務の未経験者)にマニュアルだけを渡し、作成者に質問せず最後まで業務を実行してもらう。==質問ゼロで完了できたら合格==です。途中で詰まった箇所・質問が出た箇所は、そのままマニュアルの欠陥リストになるので、Geminiに修正指示として戻します。生成AIが作った文章は体裁が整っているぶん「完成しているように見える」ため、読み返しだけの確認では欠落を見落とします。実際に手を動かしてもらうこのテストが、配布後に発生するはずだった問い合わせを先取りしてくれます。所要は15〜30分程度、対象業務1つにつき1回で十分です。

    ![マニュアル整備のBefore→After比較図。Beforeは口頭伝承のみでベテランに質問が集中し新人が業務を再現できない状態、AfterはGeminiで作成しレビューを経たマニュアルにより、新人が質問ゼロで手順を完了できる状態を対比で示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig4-beforeafter-manual-state.png)

    テストとあわせて、次のレビュー観点を最終チェックに使ってください。

    – 専門用語・社内システム名に、初出の説明が付いているか
    – 手順の要所に画面キャプチャ・写真が入っているか(文章だけで迷わないか)
    – 手順に抜けがないか(経験者には自明すぎて省かれた”暗黙の1クリック”が典型)
    – 例外が起きたときの連絡先・対処が書かれているか
    – 「どうなったら完了か」の完了状態が明記されているか

    ## Geminiでのマニュアル作成が向かない場面・限界

    Geminiでのマニュアル作成には限界もあります。主なものは3つで、(1) 曖昧な指示に弱く、丸投げでは精度が出ない、(2) 動画の特定場面のピンポイントな切り出しなど、細かい編集作業は苦手と報告されている、(3) 機密情報・個人情報を含む素材は、管理された環境と社内ルールの確認なしに扱えないこと、の3点です。加えて、前提条件の節で触れたとおり、手順そのものが標準化されていない業務や、判断の勘所が動画にも言葉にも表れない暗黙知型の業務は、そもそもこの手順の射程外です。ただし私たちの見立てでは、実際の失敗の最大要因はこれらAIの性能ではなく運用側にあります。すなわち==レビューなしの配布==です。

    ![Geminiでのマニュアル作成が効く場面・条件つきの場面・効かない場面を信号機で判定する図。青は素材がありレビュー体制もある定型業務、黄は機密情報を含む素材や動画編集を伴う作業など条件つきの領域、赤は手順が標準化されていない業務や暗黙知の比重が大きい業務を示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig5-signal-limitations.png)

    **現場でよく見る失敗パターン**は、Geminiが出したドラフトをレビューせずに配布し、古い手順や誤った専門情報が残ったまま運用されるケースです。誤りに気づいた現場はそのマニュアルを信用しなくなり、結局ベテランに直接聞く運用へ逆戻りします。こうなると「マニュアルはあるが使われない」という、着手前より始末の悪い状態になります。失敗しているかどうかの判定基準も添えておきます。**配布後1か月たっても担当者への問い合わせが減らない、むしろ増えているなら、それはレビュー不足のサインです。** マニュアルの本数ではなく、問い合わせの増減を先行指標として見てください。

    なお期待値の面では、ソフトバンクのブログで[動画からのマニュアル自動作成により作成時間を大幅に削減できた(最大90%の削減)とする検証が報告されています](https://www.softbank.jp/biz/blog/cloud-technology/articles/202412/multimodal-gws-googlecloud/)が、これは他社環境での報告値です。削減されるのは主に「ゼロから書き起こす時間」であって、レビューと運用の時間まで消えるわけではない、と読むのが実務的です。

    ## 応用|作ったマニュアルを組織のナレッジ資産にする

    マニュアルは、作った時点ではまだ「資産」ではありません。社内ナレッジベースに格納され、必要な人が(あるいはAIが)==検索して答えられる状態==になって初めて、属人化の解消という当初の目的に届きます。ファイルサーバーの奥に置かれたまま誰にも見つけられないマニュアルは、存在しないのとほぼ同じだからです。組織のナレッジの成熟度は「口頭伝承のみ → 文書化されている → Geminiなどで作成・更新が回っている → AIが検索して回答できる」の4段で捉えると整理しやすく、本記事の手順はこの2〜3段目を担います。1本目のマニュアルを作った時点で、次にどこを目指すのかを決めておくと、以降の整備が散らばりません。

    ![組織のナレッジ成熟度を4段のラダーで示す図。第1段は口頭伝承のみ、第2段はドキュメント化、第3段はGeminiによるマニュアル作成と更新の運用、第4段は社内ナレッジベースに格納されAIが検索・回答できる状態で、上の段ほど属人化が解消されることを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/gemini-manual-creation-fig6-ladder-knowledge-maturity.png)

    私たちPolarisXも、3部門・約20のAIエージェントからなるAI社員組織を自社で運用するなかで、業務のやり方をその都度文書化し、AIが参照できるナレッジベースに格納する運用を回しています。この運用で効いているのは、マニュアルの置き場所と書式が揃っていること、つまりSTEP5の設計です。文書がバラバラの場所・書式で散在していると、人にとってもAIにとっても「探せない資産」になります。

    その先の4段目、つまり「作ったマニュアルをAIに検索・回答させる」段階では、マニュアルに含まれる画面キャプチャや図表をAIが正しく読めるかという技術的な論点が出てきます。画像・図表の多いマニュアルを想定している場合は、あわせて次の記事を参照してください。

    ▶ 関連記事: [マルチモーダルRAGとは?仕組み・活用場面・限界をわかりやすく解説](/blogs/multimodal-rag)

    マニュアルの整備から、AIが社内の質問に答えられるナレッジ基盤づくりまでを一気に進めたい場合は、AI社員組織を自社で運用する私たちPolarisXがお手伝いできます。「どの業務から着手すべきか」の見極めからで構いません。お気軽に [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご相談ください。

    ## 着手チェックリスト

    最後に、この記事の手順をそのまま実行に移すためのチェックリストです。上から順に確認してください。

    – 対象業務を1つ選んだ(最初から全業務を狙わない。「1動画=1タスク」で始める)
    – その業務の「正のやり方」が関係者間で1つに決まっている(決まっていなければ先に標準化)
    – 素材がある(画面録画・動画・写真・既存資料のいずれか。動画は無料版なら5分以内に分割)
    – 機密・個人情報の扱いを確認した(法人は管理された環境か、アップロード可否の社内ルール)
    – プロンプトに「対象読者・目的・フォーマット」の3点を書いた
    – ドラフトを人がレビューした(経験者の事実確認+未経験者の新人役テスト)
    – 格納場所を1か所に決め、更新の責任者とトリガーを決めた
    – 配布1か月後に、担当者への問い合わせが減っているかを確認する予定を入れた

    ## よくある質問

    **Q. Geminiで動画からマニュアルを自動作成できますか?**
    できます。画面録画や作業動画をアップロードし、対象読者・目的・フォーマットを指定すれば、手順書のドラフトを生成できます。Googleの公式ヘルプでは執筆時点で、動画は1ファイル最大2GB・長さは合計5分まで(上位プランでは合計1時間まで)と案内されているため、長い業務は工程ごとに動画を分割してください。生成結果はドラフトであり、人のレビューを経てから配布するのが前提です。

    **Q. Geminiでマニュアル作成する際のデメリット・注意点は何ですか?**
    主な注意点は3つです。曖昧な指示では精度が出ないため、対象読者・目的・フォーマットの明示が必要なこと。動画の特定場面をピンポイントに切り出すような編集は苦手と報告されており、画面キャプチャは人が用意するほうが早いこと。そして機密情報・個人情報を含む素材は、会社として管理された環境と社内ルールの確認なしにアップロードしないことです。

    **Q. Geminiが作ったマニュアルはそのまま使ってよいですか?**
    そのままの配布は推奨しません。生成AIは誤った情報をもっともらしく書くことがあり、数値・専門手順・社内ルールの誤りは経験者の確認が必要です。また、生成直後のドラフトは構成や視覚表現を人が整えることで完成度が高まると指摘されています。未経験者にマニュアルだけで業務を実行してもらう「新人役テスト」に合格してから配布してください。

    **Q. Geminiでのマニュアル作成にお金はかかりますか?無料でできますか?**
    個人の無料版Geminiでも作成できます(アップロードできる動画の長さなどに制限があります)。法人では、2025年1月以降Google WorkspaceのBusiness・EnterpriseプランにGeminiのAI機能がアドオンなしで含まれるようになったとGoogleが発表しており、Workspace利用企業ならマニュアル作成のために新たなツールを買う必要はありません。ただし従来のアドオン契約が不要になった一方でプラン自体の料金は改定されているため、実際の負担額は自社の契約プランと更新時期で変わります。最新の料金・提供条件はGoogle公式ページで確認してください。

    **Q. GeminiとChatGPT、マニュアル作成に向いているのはどちらですか?**
    一長一短です。Geminiは動画の読み込みとGoogle Workspace連携が強みで、録画からのマニュアル化やGoogleドキュメントでの運用と相性がよい一方、ChatGPTは自然な日本語表現に強みがあるという傾向が報告されています。すでにWorkspaceを使っている会社なら、まずGeminiで始めるのが早道です。私たち自身も両者を用途で使い分けており、ツール横断の詳しい比較は本記事の範囲外としています。

    **属人化した業務のマニュアル化を、AIが答えるナレッジ基盤まで進める。** PolarisXは、AI社員「Polaris AI」の開発と自社AI社員組織の運用を手がける当事者として、「どの業務からマニュアル化すべきか」の見極めから、社内ナレッジベースの構築までご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご連絡ください。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧いただけます。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。本記事は、社内ナレッジ整備・AI導入の現場で使っている判断基準(素材の区切り方、レビューの分担、形骸化の先行指標)を、Geminiの操作手順にあわせてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [Gemini アプリでファイルをアップロードして分析する(Google・Gemini アプリ ヘルプ)](https://support.google.com/gemini/answer/14903178?hl=ja)
    – [Canvas でドキュメントやアプリなどを作成する(Google・Gemini アプリ ヘルプ)](https://support.google.com/gemini/answer/16047321?hl=ja)
    – [Gemini in Google ドキュメントを活用する(Google・ドキュメント エディタ ヘルプ)](https://support.google.com/docs/answer/14206696?hl=ja)
    – [The future of AI-powered work for every business(Google Workspace Blog、2025年)](https://workspace.google.com/blog/product-announcements/empowering-businesses-with-AI)
    – [GeminiとGoogle Workspaceの活用~動画からマニュアルの自動作成~(ソフトバンク クラウドテクノロジーブログ、2024年)](https://www.softbank.jp/biz/blog/cloud-technology/articles/202412/multimodal-gws-googlecloud/)
    – [Geminiの使い方を解説!アカウント作成から業務での実践的な活用法まで(Teachme Biz ブログ)](https://biz.teachme.jp/blog/gemini/)

  • Difyでナレッジベースを作る手順|設定・料金・自作の限界

    Difyでナレッジベースを作る手順|設定・料金・自作の限界

    Difyでナレッジベースを作り始める前に、確認してほしい前提が1つあります。それは「作れるか」ではなく、「作ったあと、自分たちで運用し続けられるか」です。対象データが決まっていて、まずは1つのデータ源(マニュアル一式・Notionの特定スペースなど)から検証を始められるなら、この記事の手順でそのまま進められます。逆に、社内の複数システムを横断してAIに答えさせたい、更新やチューニングまで含めて誰かに任せたい、という段階なら、後半の「応用|自分で運用し続けるか、社内ナレッジ基盤として任せるか」から読むほうが早道です。

    **全体像は「①データを取り込む → ②チャンク・インデックス設定で検索精度を決める → ③アプリに接続する」の==3手順==。早ければ数十分で最初の検索が動きます。** ただし難所は手順の中ではなく、動き始めたあとの「精度チューニング」と「同期の継続運用」にあります。この記事では手順に沿って、各ステップのつまずき所まで含めて確認していきます。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— 司令塔AI社員「Polaris AI」の開発と、社内ナレッジベースをRAGで接続する自社ナレッジ運用に携わるメンバーが執筆しています。

    ## Difyのナレッジベースとは|できることと、この手順が効く条件

    Difyのナレッジベースとは、PDF・Word・NotionページなどをDifyにアップロードし、AIアプリが回答の根拠として検索できる形に整理しておく機能です。仕組みはRAG(検索拡張生成)で、質問が来るたびに関連する文書の断片(チャンク)を検索し、見つかった内容を根拠にAIが回答します。つまり「AIに社内文書を暗記させる」のではなく、==「質問のたびに社内文書を検索して答えさせる」==仕組みです。プログラミングなしで構築でき、無料プランでも小規模な検証が始められる手軽さが特徴ですが、精度と運用のかなりの部分は取り込み方と設定で決まります。だからこそ、手順を「画面操作の順番」としてではなく、「どこで品質が決まるか」とセットで押さえることが重要です。

    ![Difyのナレッジベース(RAG)の仕組みを示す解剖図。文書がチャンク分割・埋め込みでベクトル化されてナレッジベースに格納され、ユーザーの質問に対して検索が走り、見つかったチャンクを根拠にLLMが回答を生成するまでの5要素を引き出し線で説明する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig1-anatomy-dify-rag-flow.png)

    ### Difyのナレッジベースとは何か(一言で)

    一言でいうと、==アップロードした文書をAIが検索して「答えの根拠」にする仕組み==です。Difyの[公式ドキュメント](https://docs.dify.ai/ja/cloud/use-dify/knowledge/readme)では、ナレッジ(Knowledge)は文書をチャンクに分割・索引化し、アプリから検索して回答に使うための機能として説明されています。処理の流れは「文書 → チャンク分割 → 埋め込み(ベクトル化)→ 検索 → LLMが回答生成」の5要素で、以降の手順①〜③はこの流れを順に組み立てていく作業に対応します。なお、Difyというツール自体(ワークフロー・エージェント機能など全体像)の解説はこの記事のスコープ外とし、ナレッジベース機能に絞って進めます。

    ### この手順が向いている場合/向いていない場合

    向いているのは、次のような場合です。

    – 対象データが決まっている(製品マニュアル・社内規程・FAQ集など、まず1つのまとまり)
    – 目的が検証・小規模利用(「本当に使えるか」をコストをかけずに確かめたい)
    – 設定を触って改善できる担当者がいる(チャンクや検索設定を試行錯誤できる)

    逆に、次の場合はDIYで作り切るより先に、進め方自体を検討したほうがよいというのが私たちの見立てです。

    – Notion・Slack・Google Drive・社内DBなど複数の情報源を横断させたい
    – 更新のたびに手作業の同期が発生する運用を、現場に定着させる自信がない
    – 精度チューニングを続ける担当者を置けない

    このタイプ分けは、ナレッジマネジメントの仕組み全体をどう選ぶかという話につながります。ツール全体の比較軸は別記事で整理しています。

    ▶ 関連記事: [ナレッジマネジメントツール比較|種類・選び方とAI活用の軸](/blogs/knowledge-management-tools)

    ### 始める前に準備するもの

    手を動かす前に揃えておくと、途中で止まらずに1周できます。必要なのは4つだけです。

    – **Difyのアカウント**(クラウド版なら無料のSandboxプランで着手できます。自社サーバーで動かすセルフホスト版もありますが、検証段階でわざわざ選ぶ理由は多くありません)
    – **モデルプロバイダーのAPIキー**(OpenAIなど。埋め込みモデルと回答生成モデルの両方で使います。ここが未設定だと手順②以降でエラーになります)
    – **対象文書のファイル一式**(まず1つのまとまりに絞る。マニュアル一式、規程集、FAQ集など)
    – **検証用の質問リスト10〜20問**(現場で実際に出た質問。ここを後回しにすると「なんとなく動いた気がする」で終わります)

    4つ目を最初に用意するのが、私たちが実務で置いている順序です。質問リストがないまま作り始めると、精度が良いのか悪いのかを判断する物差しがないまま設定をいじることになり、時間だけが溶けていきます。

    ## 手順①:データを取り込む(ファイル・Notion・Webサイト)

    最初の手順は、ナレッジベースの入れ物を作り、データを取り込むことです。Difyの「ナレッジ」メニューから新しいナレッジベースを作成し、データソースを指定します。取り込み方法は大きく3つで、==ファイルのアップロード・Notionからの同期・Webサイトからの取り込み==です。ここでの品質は「何を入れるか」でほぼ決まります。関係ない文書まで一括投入すると検索ノイズが増えるため、最初は「答えてほしい質問に対応する文書」だけに絞るのが定石です。所要時間は、ファイル数が少なければ数分〜数十分。つまずくとすれば形式の対応範囲と、後述するNotion同期の仕様です。

    ![Difyのナレッジベースへデータを取り込む3つの経路を示すステップフロー。ファイルアップロード・Notion同期・Webサイト取り込みの3ルートが1つのナレッジベースに集約される流れを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig2-steps-data-import.png)

    ### 取り込める形式(ファイル・Notion・Webページ)

    [公式の作成ガイド](https://docs.dify.ai/ja-jp/guides/knowledge-base/create-knowledge-and-upload-documents)によると、テキストファイル(PDF・Word・Markdown・TXT・HTML・CSVなど)のアップロードに加え、Notionのページを同期する方法、Webサイトの内容を取り込む方法が用意されているとされています(対応形式の詳細はプランやバージョンで変わり得るため、実際の画面で確認してください)。注意したいのは、取り込みの基本が「テキスト抽出」であることです。図面・写真・スキャン画像が主役の資料は、そのままでは検索の役に立たないことが多く、画像まで扱いたい場合は別のアプローチ(マルチモーダルRAG)の検討が必要になります。

    ▶ 関連記事: [マルチモーダルRAGとは?仕組み・活用場面・限界をわかりやすく解説](/blogs/multimodal-rag)

    ### つまずき所:Notionは「自動では」更新されない

    ここが手順①最大の落とし穴です。[公式ドキュメントのNotion同期の説明](https://docs.dify.ai/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/sync-from-notion)では、Notion側でコンテンツを更新した場合はDify側で手動の同期操作が必要で、スケジュールによる自動同期はサポートされない、画像や添付ファイルは読み込めない、とされています(執筆時点の報告値。仕様は変わり得るため一次確認を推奨します)。つまり「Notionとつないだから、あとは勝手に最新化される」とはなりません。なお、Difyが提供するナレッジベースAPIを外部から叩けば更新を自動化する余地はある、という実装報告も公開されています。ただしそれは、画面操作で完結するノーコードの範囲を出て、連携プログラムを自分たちで書き、動かし続けることを意味します。「自動化できるか」ではなく「その自動化を誰が保守するか」で判断してください。

    私たちPolarisXも、AI社員が社内ナレッジを参照する運用を自社で回していますが、この種の「元データを直したのにAIの答えが古いまま」という状態は、仕組みの新旧を問わず繰り返し見る典型症状です。原因はほぼ毎回、AIの性能ではなく==同期・更新の運用が誰の仕事か決まっていない==ことにあります。判断基準を1つ挙げるなら、「Notionを更新したら同期ボタンを押す」という運用が1か月続けて定着しないなら、それはDIY運用がすでに限界に近いサインです。その場合は担当を明確にするか、同期を仕組みに任せる構成(後述の応用)へ切り替えるべきです。

    ## 手順②:チャンク・インデックス設定で検索精度を決める

    2つ目の手順は、取り込んだ文書を「どう区切り、どう索引化するか」の設定です。地味に見えますが、==ナレッジベースの検索精度はこの設定でほぼ決まります==。決めることは主に3つ。(1) インデックス方式(高品質モードかエコノミーモードか)、(2) チャンクの区切り方(チャンク長・オーバーラップ)、(3) 検索方法(ベクトル検索・全文検索・ハイブリッド検索と、必要に応じたリランク)です。最初から最適解を狙う必要はなく、既定値で作って検索テストを回し、外れた質問からさかのぼって調整するのが現実的な進め方です。ただし「一度設定したら終わり」にはならない点は、先に知っておいてください。

    ![Difyナレッジベースのインデックス方式2種を比較した表。高品質モードは埋め込みモデルでベクトル化して意味検索ができ精度重視でコストがかかる、エコノミーモードはキーワードベースで低コストだが表記ゆれに弱い、という違いを検証用途との対応付きで示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig3-table-index-mode-comparison.png)

    ### 高品質モードとエコノミーモードの違い

    Difyのインデックス方式には、埋め込みモデルで文書をベクトル化する「高品質」モードと、キーワードベースで索引化する「エコノミー」モードがあるとされています。高品質モードは言い回しが違う質問(「有休の申請方法」と「休暇はどう取る?」など)も意味で拾える一方、埋め込みモデルの利用コストがかかります。エコノミーモードは低コストですが、表記ゆれや言い換えに弱くなります。社内文書は「同じことを違う言葉で聞かれる」のが常なので、==本気で精度を確かめたい検証なら高品質モード==を選び、コストはデータ量を絞って抑える、という組み合わせが実務的です。

    ### チャンクサイズ・オーバーラップの考え方

    チャンクとは、検索の単位になる文書の断片です。細かく切りすぎると文脈が切断されて「根拠の断片しか返ってこない」状態になり、大きすぎると無関係な内容が混ざって回答がぼやけます。オーバーラップ(隣り合うチャンクの重なり)は、区切り目で文脈が切れるのを緩和する仕組みです。また、検索は細かい断片で当てつつ回答には親となる大きな塊を渡す「Parent-Child(親子)チャンキング」という方式も提供されているとされ、規程やマニュアルのように階層構造を持つ文書と相性がよいという[実務者の検証記録](https://note.com/yosshi8448/n/nc281b3b0027a)が公開されています。まずは既定値で作り、「見出し単位で意味が完結するか」を実際の文書で確かめながら調整するのが着実です。

    ### 検索方法とTop K・スコア閾値の調整

    チャンクの次に効くのが、検索の設定です。Difyでは、意味の近さで探すベクトル検索、キーワードの一致で探す全文検索、その両方を組み合わせるハイブリッド検索が選べるとされ、ハイブリッド検索に並べ替え専用のモデル(Rerank)を組み合わせる構成が精度面で有利だという[検証記録](https://note.com/yosshi8448/n/nc281b3b0027a)が公開されています。社内文書では「型番・製品名・略語のような固有名詞での検索」と「言い回しの違う質問」が同時に来るため、固有名詞に強い全文検索と言い換えに強いベクトル検索を併用する意味は大きいと考えられます。

    あわせて調整するのが、検索で拾う件数の上限(Top K)とスコア閾値です。Top Kを絞りすぎると根拠が足りず「分かりません」が増え、広げすぎると無関係な文書が混ざって回答がぶれます。スコア閾値を上げると誤答は減りますが、答えられない質問が増えます。どちらも正解は文書の性質で変わるので、次の「できたかどうかの判定法」で述べる検索テストを回しながら、外れた質問を見て動かすのが確実です。

    ### つまずき所:精度チューニングは一度で終わらない

    私たちがRAG接続の現場で使う判断基準はシンプルで、「精度が出ない」と感じたら、モデルを疑う前に==実際のチャンクの切れ目を目で確認する==ことです。チャンクの途中で表が分断されている、見出しと本文が別チャンクに割れている。精度不良の原因は、たいていこのレベルにあります。そしてこの確認と調整は、文書を追加するたび・質問の傾向が変わるたびに発生します。もう1つの典型が、埋め込みモデルの不一致です。ナレッジベースごとに違う埋め込みモデルを使うと、同じアプリからまとめて検索できない・エラーになるという報告があり、複数のナレッジベースを作る場合は最初にモデルを統一しておくのが安全です。途中でモデルを変えると再インデックス(作り直し)が必要になる点も、データ量が増える前に知っておきたい仕様です。

    ## 手順③:アプリに接続する(チャットボット・外部ナレッジベースAPI)

    最後の手順は、作ったナレッジベースをAIアプリにつなぐことです。Difyでチャットボットなどのアプリを作成し、そのアプリの「コンテキスト」として手順①〜②で作ったナレッジベースを追加すると、回答が社内文書を根拠にしたものに変わります。ここまでで「社内文書に基づいて答えるチャットボット」が一応完成し、==最短ならここまで数十分==です。さらに、すでに社内にベクトルDBや検索基盤がある場合は、Difyの中に文書を取り込み直さなくても、外部ナレッジベースAPIで既存基盤を接続する選択肢があります。どちらの道を選ぶかは「検索の本体をDifyの中に置くか、外に置くか」の分岐です。

    ![Difyのナレッジ接続方法を選ぶ決定木。既存の検索基盤がある場合は外部APIで接続してAPI実装を行い、ない場合はDify内でナレッジベースを新規作成するノーコードの経路へ進むことを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig4-decision-external-api.png)

    ### 作成したナレッジベースをチャットボットに接続する

    アプリ側の設定画面でナレッジベースをコンテキストに追加し、「引用(出典表示)」を有効にしておくと、回答がどの文書のどの部分に基づいたかを確認できます。この出典表示は、精度検証の効率を大きく左右するので必ず有効にしてください。社内問い合わせの一次窓口として使う構成(AIヘルプデスク)は、Difyナレッジベースの代表的な用途の1つです。窓口設計や有人への引き継ぎまで含めた考え方は、別記事で扱っています。

    ▶ 関連記事: [AIヘルプデスクとは?仕組み・費用相場・失敗しない選び方を解説](/blogs/ai-helpdesk)

    ### 既存の検索基盤・ベクトルDBがあるなら外部ナレッジベースAPI

    [公式ドキュメント](https://docs.dify.ai/ja/use-dify/knowledge/connect-external-knowledge-base)によると、外部ナレッジベースAPIを実装すると、自社の既存ベクトルDBや検索インデックスをDifyのナレッジとして接続できるとされています。すでに検索基盤へ投資済みの会社が、文書の二重管理を避けながらDifyのアプリ作成機能だけを使いたい場合に有効です。ただしAPIの実装が必要になるため、ここから先はノーコードの範囲を超え、エンジニアの関与が前提になります。

    ### つまずき所:接続後にエラーが出る典型パターン

    接続まで進んだのにうまく動かない場合、公開されている検証記録では原因の典型として、(1) 埋め込みモデル関連(複数ナレッジベース間のモデル不一致や、モデルプロバイダーのAPIキー未設定・利用枠切れ)、(2) チャンク設定関連(チャンクが大きすぎてコンテキストに収まらない)、(3) セルフホスト環境での環境変数・接続設定まわり、が報告されています。切り分けのコツは「検索」と「生成」を分けて確認することです。次の手順で説明する検索テストで、まず検索単体が正しい文書を返しているかを見れば、問題がナレッジベース側にあるのかアプリ設定側にあるのかを素早く特定できます。

    ## できたかどうかの判定法と、無料でどこまでできるか

    「作れた」と「使える」は別物です。判定に使うのは、Difyのナレッジベースに用意されている検索テスト(Retrieval Testing)で、想定質問を入力すると、どのチャンクがどんなスコアで返るかを確認できます。判定の手順は、(1) 現場で実際に出る質問を10〜20個集める、(2) 検索テストで正しい文書が上位に返るかを確認する、(3) アプリ経由で回答の内容と出典を確認する、の3段階です。==「AIの答えが正しいか」の前に「検索が正しい文書を返しているか」を見る==のが鉄則で、検索が外れていれば、どんなに賢いモデルでも正しい回答は作れません。あわせて、この検証を無料枠でどこまでできるかも整理しておきます。

    ![Difyの無料プランと有料プランのナレッジベース容量を比較するスケール図。2026年7月27日に公式料金ページで確認したSandboxプラン50MBとProfessionalプラン5GBを帯で対比し、最新情報は公式ページで確認する旨を注記した図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig5-gauge-storage-capacity.png)

    ### 無料プランでどこまでできるか(公式掲載値)

    2026年7月27日に[公式料金ページ](https://dify.ai/pricing)で確認した掲載値では、無料のSandboxプランはナレッジベース容量==50MB==・ドキュメント数50件・メッセージクレジット200回、有料のProfessionalプランは月額59ドル・容量5GB・ドキュメント数500件です。プラン内容・価格は改定されやすいため、利用前に同ページで最新情報を確認してください。実務的な目安としては、無料枠は「1つのデータ源で検索テストを回す検証」には十分ですが、部門をまたぐ文書量や日常利用のクレジット消費を考えると、本番運用では有料プラン前提で考えるのが現実的です。無料でどこまで粘るべきかという判断軸は、AIエージェント全般の無料活用を扱った[別記事](/blogs/ai-agent-free)でも整理しています。

    ### 失敗と分かる基準を先に決めておく

    検証には「やめ時・切り替え時」の基準もセットで決めておくべきです。私たちが提案する基準は、==本番投入後1か月==で、(1) 想定質問への回答精度が改善傾向に乗らない、(2) 同期・更新の作業が特定の担当者の負担として滞留し始めている、のどちらかに該当したら、DIYの型で回し続けるには限界が来ているサインだと判断する、というものです。逆に1か月でこの2つをクリアできているなら、その構成のまま対象文書を広げていけます。基準を先に決めておくことで、「なんとなく使われなくなった」という一番もったいない失敗を避けられます。

    ## 応用|自分で運用し続けるか、社内ナレッジ基盤として任せるか

    ここまでの3手順を実際に回すと、DifyのDIY構築の得意・不得意がはっきり見えてきます。得意なのは、単一データソース・検証目的・設定を触れる担当者がいる場合で、この条件ならDify単体で十分に実用になります。不得意なのは、複数の情報源の横断・自動での鮮度維持・チューニングの継続で、これらはツールの機能ではなく「運用の仕組み」の問題として残り続けます。つまり分かれ道は、==ナレッジ運用を自分たちの継続業務にするか、仕組みごと任せるか==です。ここでは、その判断材料を整理します。

    ![Dify単体でDIY運用を続ける場合と、社内ナレッジ基盤の構築・運用を任せる場合の対比2カラム図。DIY側は低コストで始められるが手動同期・継続チューニング・担当者の属人化が残ること、任せる側は複数の情報源を接続して更新・改善まで仕組みに含められることを対比する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/dify-knowledge-base-fig6-contrast-diy-vs-delegate.png)

    手順の中で見てきたDIYの限界を並べると、次の3つに集約されます。

    – **同期が手動**: Notion連携でも自動更新はされず、「同期ボタンを押す係」が要る
    – **チューニングが継続業務**: チャンク・検索設定の調整は、文書と質問が増えるたびに発生する
    – **運用が属人化する**: 設定の意図を知る人が1人しかいない状態になりやすく、その人の異動・退職で止まる

    この3つが許容範囲なら、DIY継続が合理的です。一方、私たちPolarisXが提供している司令塔AI社員「Polaris AI」は、この限界のほうを解決する設計を採っています。導入時にNotion・Slack・Google Drive・社内データベースといった複数の情報源を接続し、以降はAI社員が必要な情報を自律的に取りに行くため、「コピペで教える」「手動で同期する」という運用そのものをなくす発想です。私たち自身、3部門・約20のAIエージェントで自社運用し、その全員が同じ社内ナレッジベースを参照して働いています。AI社員という考え方自体は[別記事](/blogs/ai-employee)で詳しく説明しています。

    **Difyでの検証を経て「複数の情報源を横断したい」「継続運用まで任せたい」というフェーズに来ているなら、社内ナレッジベースの構築からご一緒できます。現状のデータ源と使いたい場面を添えて、[contact@polarisx.ltd](mailto:contact@polarisx.ltd) まで気軽にご相談ください。**

    ## 着手チェックリスト

    最後に、この記事の手順をそのまま始められるチェックリストを置いておきます。上から順に埋まれば、着手して問題ありません。

    – 対象データを決めたか(まず1つのデータ源。「答えてほしい質問」に対応する文書だけに絞る)
    – 取り込み形式を確認したか(テキスト中心か。図面・画像が主役ならマルチモーダルRAGの検討へ)
    – モデルプロバイダーのAPIキーを設定したか(未設定は手順②以降のエラー原因の筆頭)
    – インデックス方式を決めたか(精度検証なら高品質モード。コストはデータ量で調整)
    – 複数のナレッジベースを作る予定なら、埋め込みモデルを最初に統一したか(後から変えると再インデックスが必要)
    – 検証用の質問を10〜20個用意したか(現場で実際に出た質問から集める)
    – 出典表示(引用)を有効にしたか(検証効率が大きく変わる)
    – 同期・更新の担当を決めたか(Notion連携は手動同期。「押す係」がいない構成は形骸化する)
    – 失敗と判断する基準を決めたか(例: 本番投入後1か月で精度が改善傾向に乗らない/同期が滞留)
    – 複数の情報源を横断する予定があるか(あるなら、DIY継続か基盤構築かを早めに判断する)

    ## よくある質問

    **Q. DifyとNotionを連携すると、Notion側の更新は自動で反映されますか?**
    自動では反映されません。公式ドキュメントによると、Notion側の更新後はDify側で手動の同期操作が必要で、スケジュールによる自動同期はサポートされないとされています(執筆時点の報告値。画像や添付ファイルも読み込めないとされます)。ナレッジベースAPIを使って更新を自動化する実装報告はありますが、その場合は連携プログラムの開発と保守を自前で抱えることになります。運用に組み込むなら「誰がいつ同期するか」を先に決めておくのが実質的な必須条件です。

    **Q. Difyのナレッジベースは無料でどこまで使えますか?容量制限は?**
    執筆時点で確認できた報告値では、無料のSandboxプランは容量50MB・ドキュメント50件・メッセージクレジット200回程度までとされ、有料のProfessionalプラン(月額59ドルとの報告)で5GB・500件などに拡張されるとされています。1つのデータ源での検索精度検証なら無料枠で足りることが多い一方、本番運用は有料前提が現実的です。最新の内容は必ず公式料金ページで確認してください。

    **Q. Difyでナレッジベースがうまく使えない・エラーになる原因は何ですか?**
    公開されている検証記録で典型として報告されているのは、(1) 埋め込みモデル関連(複数ナレッジベース間のモデル不一致・モデルプロバイダーのAPIキー未設定や利用枠切れ)、(2) チャンク設定関連(大きすぎ・分割位置の不良)、(3) セルフホスト環境の環境変数まわり、です。切り分けは検索テストで「検索が正しい文書を返すか」をまず確認するのが近道です。

    **Q. Difyのナレッジベースはどんな用途に向いていますか?**
    向いているのは、社内FAQ・製品マニュアル・規程集など「テキスト中心で、範囲が決まった文書」を根拠に答えさせる用途です。代表例は社内問い合わせの一次対応チャットボットや、マニュアル検索の窓口です。逆に、複数の社内システムを横断した検索や、画像・図面が主役の資料、更新頻度が高く鮮度が命の情報は、Dify単体のDIYでは運用負荷が大きくなりやすい領域です。

    **社内ナレッジをAIに任せる第一歩を、確実に踏み出す。** PolarisXは、司令塔AI社員「Polaris AI」の開発と、約20のAIエージェントが社内ナレッジベースを参照して働く自社運用の当事者として、「どのデータから始めるか」「DIYと構築支援のどちらが合うか」の見極めからご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご連絡ください。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧いただけます。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。本記事は、社内ナレッジ整備とRAG接続の現場の視点から、Difyのナレッジベース構築手順に実務の判断基準とつまずき所を加えてまとめました。料金・仕様など外部の数値は執筆時点の報告値であり、一次情報は本文と参考文献のリンク先で確認できます。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [ナレッジ – Dify Docs(Dify公式ドキュメント)](https://docs.dify.ai/ja/cloud/use-dify/knowledge/readme)
    – [ナレッジベース作成 – Dify Docs(Dify公式ドキュメント)](https://docs.dify.ai/ja-jp/guides/knowledge-base/create-knowledge-and-upload-documents)
    – [Notionからデータを同期 – Dify Docs(Dify公式ドキュメント)](https://docs.dify.ai/ja/cloud/use-dify/knowledge/create-knowledge/import-text-data/sync-from-notion)
    – [外部ナレッジベースとの接続 – Dify Docs(Dify公式ドキュメント)](https://docs.dify.ai/ja/use-dify/knowledge/connect-external-knowledge-base)
    – [Dify 料金ページ(Dify公式)](https://dify.ai/pricing)
    – [Dify でナレッジ内文章の検索精度を高めるための設定(note・実務者の検証記録)](https://note.com/yosshi8448/n/nc281b3b0027a)

  • AIエージェントの自作方法|ノーコードでの作り方・注意点まで解説

    AIエージェントの自作方法|ノーコードでの作り方・注意点まで解説

    AIエージェントは、条件が揃えば自分たちの手で作れます。ただし、ここで紹介する手順が効くのは次の3つが当てはまる場合です。**(1) 任せたい業務を1つに絞れている、(2) AIに渡せる社内の資料・データがある、(3)「動くものを試してから決める」進め方でよい**。逆に、複数業務をまとめて自動化したい、あるいは請求・契約のように間違いが許されない処理を最初から任せたい、という段階であればこの手順だけでは足りません。まず自分たちの手で1体を動かし、どこまでが自作で届く範囲かを見極めるための記事です。

    > **手順の全体像(5段)**
    > 任せる業務を1つ決める → ノーコード/ローコード/フルコードのルートを選ぶ → 最小構成で動かす → 社内データ・業務ツールにつなぐ → 小さく試して合否を判定する。
    > 最初の1体が「とりあえず動く」までは、業務の複雑さ次第で==早ければ数日、長くても数週間==。難所は作ること自体ではなく、本番の雑多な入力に耐えさせる最後の作り込みです。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用に携わるメンバーが執筆しています。

    ## この手順が向いている人・向いていない人

    自作が向いているのは、「特定の業務を、社内の文脈を踏まえて、繰り返し処理してほしい」という目的がはっきりしている人です。市販のAIサービスは汎用的に作られているぶん、自社の呼び方・自社の判断基準・自社の資料には合いません。そこを埋めるのが自作の価値です。一方で、AIに何を任せたいかがまだ言葉にできない、渡せる社内資料がほとんどない、作った後に手入れする人を置けない。このいずれかに当てはまるなら、==自作より先にやることがあります==。作ること自体は今や難しくありませんが、作った後に直し続ける手間は消えません。自作は「安く手に入る」のではなく「自社に合わせられる代わりに、保守を自分たちで引き受ける」選択だと理解しておくと、後で判断を誤りません。

    ### まずは1つの業務で小さく試したい人向け(自作のメリット・デメリット)

    自作の利点は3つに整理できます。第一に、自社の業務手順や用語に合わせて中身を書き換えられること。第二に、既製サービスの月額を積み上げずに、小さく始めて効果を確かめられること。第三に、作る過程で「どの業務がAIに向くか」という知見が社内に残ることです。

    一方でデメリットも3つあります。品質の責任が自社にあること(誤った出力を止めるのも自社)、動かし続ける保守が自社負担になること、そして評価の仕組みを作らないと精度が上がらないことです。特に3つ目は見落とされがちで、==作りっぱなしのAIエージェントは静かに劣化します==。参照している社内資料が古びれば、出力も同じだけ古くなるからです。

    小さく始めるなら、最初の1体は「間違えても取り返しがつく業務」に当てるのが鉄則です。社内向けの問い合わせ一次対応、議事録の要約、提案書のたたき台づくりなどが該当します。逆に、社外に出す文書や金額が絡む処理を最初の題材にすると、確認の負荷が高すぎて検証が進みません。

    ▶ 関連記事: [AI社員とは?意味・違い・費用と中小企業の導入判断を解説](/blogs/ai-employee)

    ### ノーコード・ローコード・フルコードの3ルート概観

    ![AIエージェントの作り方をノーコード・ローコード・フルコードの3ルートで比較した表。Dify・GPTs・Coze・Copilot、n8n・ZapierとAI機能、PythonとLangGraphなどの代表的な道具に加え、着手のしやすさ、向く用途、弱みを並べ、ノーコードから必要な部分だけコードへ移す進め方を示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-diy-fig1-table-route-comparison.png)

    作り方のルートは大きく3つです。**ノーコード**は画面操作だけで組み立てる方式で、Dify、OpenAI の GPTs、Coze、Microsoft の Copilot Studio などが代表例です。**ローコード**は業務ツール間の自動化に AI を差し込む方式で、n8n や Zapier のような自動化ツールと AI の組み合わせが該当します。**フルコード**は Python などで実装する方式で、[LangChain](https://www.langchain.com/langchain) や LangGraph、CrewAI、AutoGen といったフレームワークが使われます。

    | ルート | 代表的な道具 | 着手のしやすさ | 向く用途 | 弱いところ |
    |—|—|—|—|—|
    | ノーコード | Dify/GPTs/Coze/Copilot Studio | アカウント登録だけで着手できる | 社内問い合わせの一次対応、要約、下書き生成 | 細かい制御・独自処理は頭打ちになる |
    | ローコード | n8n/Zapier+AI機能/ノーコードツールのAPI連携 | 一部の設定・簡単なスクリプトが必要 | 既存の業務ツール間の処理にAIを差し込む | 連携が増えるほど壊れやすく、原因の切り分けが難しい |
    | フルコード | Python+LangChain/LangGraph/CrewAI/AutoGen | 開発環境・APIキー・実装できる人が必要 | 独自ロジック、大量処理、既存システムへの組み込み | 保守・評価の体制がないと動かし続けられない |

    選び方の考え方はシンプルで、**「作れるか」ではなく「直し続けられるか」で選ぶ**ことです。フルコードで作れば自由度は上がりますが、書いた本人が異動・退職した瞬間に誰も触れなくなります。社内に実装できる人が1人しかいないなら、その1人が忙しくなった時点で止まる前提で選択してください。実務では、まずノーコードで動くものを1つ作って効果を確かめ、必要になった部分だけコードに置き換えていく段階的な進め方が支持されています。私たちも、この「小さく作って、必要になったところだけ作り込む」順序を推奨します。

    ### 複数業務の自動化や複数エージェントの連携を考えているなら別の入口へ

    最初から「営業も経理も問い合わせも」と広げると、ほぼ確実に途中で止まります。理由は技術ではなく、参照させる社内情報の整備が業務ごとに必要になるからです。複数のAIエージェントを役割分担させて連携させたい場合は、単体を作る手順とは別に、司令塔をどう置くか・情報をどう共有するかという設計が要ります([複数AIエージェントの連携](/blogs/multi-ai-agent))。また「作らずに、完成されたサービスから選びたい」のであれば、選定軸を整理するほうが早く着地します([AIエージェントの比較・選び方](/blogs/ai-agent-comparison))。この記事は、==単体のAIエージェントを1つ作り切るところまで==を扱います。

    ## 自作前の準備 — 目的・データ・ツールの棚卸し

    準備は「目的」「データ」「道具」の3点だけです。目的は、任せる業務を1つに絞って、入力(何を受け取るか)と出力(何を返すか)を1文で書けるところまで具体化します。データは、AIに参照させる社内資料の置き場所・更新責任者・公開範囲を洗い出します。道具は、選んだルートに応じたアカウントやAPIキー、コードで作るなら実行環境です。この3点が揃わないまま作り始めると、Step2以降で必ず戻ることになります。特に見落とされやすいのがデータの棚卸しで、==AIエージェントの精度は、渡せる社内情報の質でほぼ決まります==。逆に言えば、資料が整理されていない状態で高性能なモデルを選んでも、返ってくる答えは曖昧なままです。準備に半日かけるほうが、作り直しより早く終わります。

    ![AIエージェント自作の前に確認する準備チェックリストのカード。目的(任せる業務を1つに絞る・入力と出力を1文で書く)、データ(参照先の資料・更新責任者・公開範囲)、道具(アカウント・APIキー・実行環境・課金上限)の3ブロックに分けてチェック項目を並べる](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-diy-fig2-checklist-prerequisites.png)

    ### 最初の業務を1つに絞る(スコープの決め方)

    最初の業務は、次の3条件で選びます。**(1) 繰り返し発生する**(月に何度も起きる)、**(2) 手順が言葉にできる**(人に引き継げる説明がある)、**(3) 間違えても取り返しがつく**(社内向け・下書き段階)。この3つが揃う業務は、AIエージェントの効果が最も出やすく、検証も速く回ります。

    絞り込めたら、次の1文を書いてください。「**〈誰〉が〈何〉を渡すと、〈何を参照して〉〈どの形式で〉返す**」。例えば「営業担当が顧客名と要件を渡すと、過去の提案資料と製品資料を参照して、提案書のたたき台を見出し付きで返す」といった具合です。この1文が書けないうちは、まだ業務が絞れていないサインです。曖昧な目的のまま作り始めたエージェントは、出力が毎回ぶれて、結局「自分でやったほうが早い」と言われて使われなくなります。

    ### AIに渡す社内データ・ツールの棚卸し

    次に、その業務で参照する情報がどこにあるかを洗い出します。Slack、Notion、Google Drive、共有サーバー、基幹システム、そして「担当者の頭の中」です。実際にはこの最後が一番多いというのが現場の感覚です。棚卸しでは、資料ごとに**置き場所・最終更新日・更新する人・見せてよい範囲**の4項目を書き出します。

    ここで判断すべきは、「今あるものだけで足りるか」です。足りない場合の選択肢は2つ。範囲を狭めて足りる業務に切り替えるか、先に資料を整備するかです。よくある失敗は、資料が足りないまま作り始めて、AIが推測で答えるのを「性能が悪い」と誤診してしまうことです。社内情報の整備そのものを設計したい場合は、ナレッジ基盤の選び方から入るほうが遠回りに見えて確実です([社内ナレッジ管理ツールの選び方](/blogs/knowledge-management-tools))。

    ### ルート別に必要なもの(アカウント・APIキー・実行環境)

    ノーコードで作るなら、必要なのはツールのアカウントと、モデルを使うためのAPIキー(ツール側のクレジットに含まれる場合もあります)だけです。無料枠は各社が用意していますが、**利用できるアプリ数やメッセージ数に上限があり、条件は変わります**。金額や上限は必ず各社の公式ページで最新の内容を確認してください(例: [Difyの料金ページ](https://dify.ai/jp/pricing))。

    フルコードなら、Python の実行環境、モデル提供元のAPIキー、コードの保管場所(リポジトリ)が要ります。ローコードなら自動化ツールのアカウントと、つなぐ先の業務ツールの接続権限です。

    ルートを問わず、着手前に必ずやっておくことが1つあります。**APIの利用上限(課金アラート・上限額)を先に設定しておく**ことです。作り始めてから設定しようとすると、たいてい忘れます。試行錯誤の段階では処理を何度も回すため、上限を決めていないと想定外の請求につながります。

    ▶ 関連記事: [ChatGPTでAIエージェントを作る方法と使い方](/blogs/ai-agent-chatgpt)

    ## AIエージェントの作り方 — 4つのステップ

    作る作業そのものは4段階です。**Step1で役割と指示(プロンプト)を設計し、Step2でツールを選んで最小構成を組み、Step3で社内データや業務ツールにつなぎ、Step4で小さく動かして試す**。ノーコードでもフルコードでも、この順序は変わりません。順序を守る理由は、後の工程ほど手戻りのコストが高いからです。接続を先に作り込んでから役割を変えると、権限設定からやり直しになります。各ステップには決まったつまずき所があり、==多くの挫折はStep3とStep4で起きます==。作れないから止まるのではなく、「動いたのに使われない」「本番データで精度が落ちる」という形でつまずきます。以下、各ステップで何をするかと、その手前で何を疑うべきかをセットで説明します。

    ![AIエージェント自作を小さく進める4ステップのフロー図。役割と指示、最小構成、読取専用から始めるデータ接続、実際の依頼文を使う実務テストを順にたどり、各段階の注意点を添える](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-diy-fig3-steps-diy-flow.png)

    ### Step1 役割と指示(プロンプト)を設計する

    最初にやるのは、AIエージェントの「職務記述書」を書くことです。最低限、次の5要素を書き出します。

    1. **役割**: 何の担当か(例: 社内問い合わせの一次対応担当)
    2. **入力**: 何を受け取るか(質問文、顧客名、議事録のテキストなど)
    3. **参照先**: どの情報を根拠にするか(指定した社内資料のみ、など)
    4. **出力形式**: どんな形で返すか(見出し付き/箇条書き/指定の項目を必ず含む)
    5. **やってはいけないこと**: 推測で答えない、金額や契約条件は回答しない、判断に迷ったら人にエスカレーションする

    **つまずき所: 指示が曖昧だとエージェントは迷走します。** 「丁寧に対応して」「うまくまとめて」といった指示は、人には通じてもAIには通じません。特に効くのは5番目の「やってはいけないこと」で、ここが空欄のまま本番に出すと、AIは分からないことを分からないと言わずに、それらしい答えを作ります。私たちがプロンプトを見直すときも、まず**禁止事項とエスカレーション条件が書かれているか**を確認します。

    ### Step2 ツールを選んで最小構成をつくる

    Step1で書いた職務記述書を、選んだツールに入れて動かします。ノーコードツールなら、アプリを新規作成し、指示文を貼り、モデルを選ぶだけで最初の応答が返ります。ここでのゴールは「**入力1つ・参照先1つ・出力1つ**」の最小構成が最後まで通ることです。

    **つまずき所: 最初から複雑な連携を組もうとすると、どこが悪いか分からなくなります。** 検索も承認フローも通知も一度に組み込むと、期待した答えが返らないときに原因の切り分けができません。まずは参照先なし(AIの知識だけ)で応答の形を確認し、次に参照先を1つだけ足す。この順で進めると、問題が起きた箇所が必ず「直前に足したもの」に限定されます。動くものが1本通ってから、機能を1つずつ足していくのが結果的に最短です。

    ### Step3 社内データ・外部ツールに接続する

    ここで初めて、社内の資料やツールにつなぎます。ノーコードツールなら資料をアップロードするか、Google Drive などと連携させます。接続の設計で決めるのは3点、**どの範囲を読ませるか・書き込みまで許すか・誰の権限で動かすか**です。

    **つまずき所: 権限設計を後回しにすると、後で全部やり直しになります。** よくあるのは、手元にある資料をまとめてアップロードしてしまい、後から「この資料は一部の人しか見られない前提だった」と気づくケースです。AIエージェントは、権限のことを何も知らないまま、参照できる情報を等しく回答に使います。原則は人と同じで、**まずは読み取り専用・最小範囲から始める**こと。書き込みや送信を伴う操作(メール送信、外部システムの更新)は、最初は人の承認を挟む形にします。国が示す「AI事業者ガイドライン」も、利用する事業者側にセキュリティ対策や人間中心の考え方といった留意事項を示しており、AIに任せきりにしない運用が前提とされています([AI事業者ガイドライン](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html))。==入力・出力・実行の3か所にガードレールを置く==、と覚えておくと設計が漏れません。

    ### Step4 小さく動かして試す

    最後に、実際の業務データで動かします。ここが自作の成否を分ける工程です。

    **つまずき所: 整ったサンプルデータだけで満足してしまうこと。** 試作段階では、きれいに整形した例文を渡すため、たいてい良い答えが返ります。ところが本番では、誤字のある問い合わせ、前提が省略された依頼、複数の質問が1文に混ざったメッセージが飛んできます。試作では動いたのに本番で精度が落ちる、という食い違いは、AI導入の失敗要因として広く指摘されている論点です。

    回避策は単純で、**きれいな例文ではなく、直近の実際のやり取りをそのまま投げる**ことです。私たちが自社のAIエージェントを検証するときも、想定質問ではなく実際に届いた依頼文を、加工せずにまとめて流します。加えて、その業務を普段やっている担当者本人に触ってもらいます。作った人が試すと無意識に「AIが答えやすい聞き方」をしてしまい、本番の入力とはずれた検証になるためです。

    ## できたかどうかの判定法 — 本番に乗せる前に確認すること

    「完成」の基準は、正答率の高さではなく次の3点です。**(1) 再現性**(同じ入力に対して毎回ほぼ同じ品質で返るか)、**(2) 根拠**(どの資料を見て答えたか示せるか)、**(3) 失敗の仕方**(分からないときに、それらしい答えを作らずに止まれるか)。この3つが揃っていれば、多少精度が低くても運用でカバーできます。逆に、たまたま良い答えが返るだけのエージェントは、業務に乗せた瞬間に信頼を失います。判定は、実際の担当者が実データで20〜30分触るだけでも十分に傾向が見えます。==「自分でやったほうが早い」と言われたら、それが不合格のサインです==。理由はたいてい、精度そのものではなく、確認にかかる手間が業務時間を上回っていることにあります。

    ![AIエージェントの試作と本番のギャップを示す比較図。左は整った文書を前に制作者が順調に確認する試作、右は誤りや複数の問い合わせを含む文書を前に実務担当者が困る本番の状態を対比する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-diy-fig4-beforeafter-poc-production.png)

    ### 精度・ハルシネーションのセルフチェック

    確認するのは3つです。第一に、**同じ質問を数回投げて答えがぶれないか**。ぶれる場合は指示文の情報が足りていません。第二に、**根拠を答えられるか**。「どの資料を見て答えましたか」と聞いて出典を返せないなら、その回答は推測を含んでいる可能性があります。第三に、**答えられない質問に「分かりません」と言えるか**。社内資料に載っていないことをわざと聞いて、素直に不明と返し、必要なら人に回すよう促せるかを見ます。

    ハルシネーション(事実に基づかない出力)は仕組み上ゼロにはできません。だからこそ、**AIに完璧を求めるのではなく、間違いが混ざる前提で確認の当番を決める**ほうが現実的です。社外に出す文書と、金額・契約・法務が絡む出力は、人の確認を必ず挟む線引きにしておきます。

    ### コスト・無限ループのチェック

    自作したエージェントを動かし始めてから顕在化しやすいのが、コストと暴走です。自律的に動くAIエージェントは、自分で次の手順を決めて処理を続けるため、条件次第では同じ処理を延々と繰り返します。本番運用の段階で「無限ループ」「コスト爆発」「デバッグ不能」といった壁に直面する、という指摘は複数の解説で共通しています。

    対策は先に仕込んでおきます。**(1) 1回の依頼で実行するステップ数の上限を決める、(2) 応答が返らないときのタイムアウトを設定する、(3) APIの課金アラートと上限額を設定する、(4) 実行ログを残して後から追えるようにする**。特に4番目は軽視されがちですが、ログがないと「なぜその答えになったか」を誰も説明できなくなり、改善が止まります。作りながらでは面倒に感じても、本番に乗せる前の最後の作業として必ず入れてください。

    ## 自作の先にある壁 — 内製を続けるか、外注・相談に切り替えるか

    自作で最初の1体を動かすところまでは、多くのチームがたどり着けます。壁になるのはその先、「試して良かったので、業務に本当に乗せる」段階です。ここから先に必要なのは、AIの賢さではなく、**例外処理・ナレッジの更新・権限と責任分界・保守の担当**という運用の作り込みで、いずれも地味で継続的な仕事です。==動くものを作る難しさと、任せて安心できる状態を保つ難しさは別物です==。この違いを早く認識できたチームほど、内製で伸ばす範囲と、外部の力を借りる範囲をうまく線引きできます。以下では、私たちが自社のAI社員組織を運用する中で繰り返しぶつかってきた壁と、切り替えの判断材料を共有します。

    ![内製を続けるか外注・相談に切り替えるかを判定する決定木の図。分岐は「作った人以外が直せるか」「例外処理が収束しているか」「参照する社内資料を更新する担当がいるか」で、Yesなら内製継続、Noなら専門家への相談や外注へ進む経路を示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-diy-fig5-decision-build-or-outsource.png)

    ### 自作でよくぶつかる壁(現場で繰り返し見るパターン)

    私たちPolarisXは、マーケティング・財務・営業の3部門・約20のAIエージェントからなるAI社員組織を、自社で設計・実装・運用しています。その当事者として言えるのは、**ノーコードでも「動くもの」はすぐ作れる。難しいのは、作ったものを業務に任せられる状態で維持することだ**、という点です。現場で繰り返し起きるのは次の4つです。

    – **例外処理のいたちごっこ**: 想定外の入力が来るたびに指示文へ条件を書き足す。すると指示文が長くなり、今度は別のケースで挙動が変わる。
    – **ナレッジの鮮度切れ**: 参照している資料が更新されず、正しい手順を答えられなくなる。AI側は何も壊れていないので、原因が見つけにくい。
    – **権限と責任分界の曖昧さ**: 誰の権限で動いているのか、出力を誰が承認するのかが決まっておらず、事故が起きるまで気づかない。
    – **作った人しか直せない**: 設定もプロンプトも1人の頭の中にあり、その人が忙しくなった瞬間に更新が止まる。

    **どうなったら自作の限界か(反証可能なサイン)**。次のいずれかが起きたら、作り方ではなく体制の問題だと判断してください。**(1) 例外を1つ潰すたびに新しい例外が生まれ、指示文が膨らみ続けている。(2) 出力の確認に人が使う時間が、その業務を自分でやる時間を上回っている。(3) 作った本人以外に、直せる人が社内に1人もいない。** どれも精度の話ではなく、続けられるかどうかの話です。

    ### 「まだ自作で伸ばせるか/専門家に相談すべきか」の見極め

    判断材料は3つです。**範囲**(1業務で足りるか、部門をまたぐか)、**責任**(間違えたときの影響が社内で収まるか、社外・金銭に及ぶか)、**担い手**(保守する人を業務として置けるか)。1業務・社内向け・担当を置ける、の3つが揃うなら内製で伸ばせます。1つでも欠けるなら、その部分だけ外部の力を借りるのが現実的です。

    具体的には、部門をまたいで複数のエージェントを連携させたくなった時点で、司令塔をどこに置くかという設計の問題に変わります([複数AIエージェントの連携](/blogs/multi-ai-agent))。開発そのものを任せたいなら発注先の選定基準が必要になり([AI開発会社の選び方](/blogs/ai-development-company))、「どの業務から手をつけるべきか」の整理から相談したいなら導入支援という選択肢もあります([AIコンサルティングの選び方](/blogs/ai-consulting))。

    **自作してみて「動いたが、任せ切れない」と感じたなら、その感覚が次の一手の材料です。** PolarisXは、AI社員「Polaris AI」の開発と自社AI社員組織の運用を手がける当事者として、内製で伸ばす範囲と任せる範囲の線引きからご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へお気軽にご連絡ください。

    ▶ 関連記事: [複数AIエージェントの連携とは?仕組みと設計の考え方](/blogs/multi-ai-agent)

    ## 着手チェックリスト

    そのまま上から順に潰していける形にしました。作業を始める前に、この3ブロックを手元に置いてください。

    **着手前(30分〜半日)**

    – 任せる業務を1つに決め、「〈誰〉が〈何〉を渡すと、〈何を参照して〉〈どの形式で〉返す」を1文で書いた
    – その業務が「繰り返し起きる/手順を言葉にできる/間違えても取り返しがつく」の3条件を満たしている
    – 参照させる資料の置き場所・最終更新日・更新する人・見せてよい範囲を書き出した
    – ノーコード/ローコード/フルコードのどれで作るかを、「直し続けられるか」を基準に決めた
    – APIの課金アラートと上限額を設定した

    **作りながら(数日〜数週間)**

    – 役割・入力・参照先・出力形式・やってはいけないことの5要素を指示文に書いた
    – 判断に迷ったときのエスカレーション先(人)を指示文に明記した
    – 参照先なしの最小構成で1本通してから、機能を1つずつ足した
    – 接続は読み取り専用・最小範囲から始め、書き込みや送信には人の承認を挟んだ
    – 実行ステップ数の上限とタイムアウトを設定した

    **判定(本番に乗せる前)**

    – きれいな例文ではなく、直近の実際の依頼文をそのまま流して試した
    – その業務の担当者本人に触ってもらった
    – 同じ入力で答えがぶれないこと、根拠を示せること、分からないと言えることを確認した
    – 出力を誰がどこまで確認するか、線引きを決めた
    – 実行ログが残り、後から挙動を追えるようにした

    ## よくある質問

    **Q. AIエージェントは無料で自作できますか?費用はどれくらいかかりますか?**
    無料の範囲で試すこと自体は可能です。主要なノーコードツールは無料枠を用意しており、まず1体を動かして感触をつかむ用途には足ります。ただし利用できるアプリ数・メッセージ数などに上限があり、条件も改定されるため、金額や上限は各社の公式料金ページで最新の内容を確認してください。継続利用ではモデル利用分の従量課金が別途かかるのが一般的です。無料でどこまでできるかの横断比較は[無料で使えるAIエージェント](/blogs/ai-agent-free)で扱っています。

    **Q. AIエージェントの自作におすすめのツールは何ですか(Dify/GPTsなど)?**
    用途と体制で決まります。画面操作だけで始めたいなら Dify、GPTs、Coze、Copilot Studio などのノーコードツール、既存の業務ツール間の処理に差し込みたいなら n8n や Zapier のような自動化ツール、独自ロジックや大量処理が必要なら Python と LangChain・LangGraph・CrewAI・AutoGen といったフレームワークが選択肢になります。選ぶ基準は機能の多さではなく、**社内で直し続けられるか**です。ChatGPT の範囲で完結させたい場合は[ChatGPTでAIエージェントを作る方法](/blogs/ai-agent-chatgpt)を参照してください。

    **Q. 自作したAIエージェントがうまく動かない・失敗する原因は何ですか?**
    原因はおおむね4系統に分かれます。指示が曖昧で禁止事項が書かれていない(Step1の不足)、参照させる社内資料が足りないか古い(準備の不足)、権限や接続の設定が業務の前提と合っていない(Step3の不足)、そして整ったサンプルデータでしか検証していない(Step4の不足)です。試作では動いたのに本番で精度が落ちるという食い違いは広く指摘されており、実際の依頼文で担当者本人が検証することが最短の対策になります。

    **Q. AIエージェントの自作にはどれくらいの期間がかかりますか?**
    業務の複雑さと参照する社内資料の整備状況で変わります。ノーコードで単純な業務なら、動くものは早ければ数日、要件整理からプロトタイプ、社内での試用、本番リリースまでを段階的に進めると数週間規模、という報告が見られます。ただしこれは「動くまで」の目安で、例外処理や権限設計、ナレッジの更新体制まで含めた本番運用の作り込みには、別途の時間と担当者が必要だと見込んでください。

    **自作の次の一手を一緒に考えます** — PolarisXは、AI社員「Polaris AI」の開発と自社AI社員組織(3部門・約20のAIエージェント)の運用を手がける当事者として、「どこまで内製で伸ばせるか」「どこから任せるべきか」の見極めからご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご連絡ください。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧いただけます。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(マーケティング・財務・営業の3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。本記事は、AIエージェントをゼロから設計・実装し、運用し続けている現場の視点から、一般的な作り方の解説に実務の判断基準を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [AI事業者ガイドライン(第1.2版)(総務省・経済産業省、2026年)](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html)
    – [プランと料金(Dify 公式)](https://dify.ai/jp/pricing)
    – [LangChain: Open Source AI Agent Framework(LangChain 公式)](https://www.langchain.com/langchain)

  • 社内チャットボットの選び方|タイプ別比較と失敗しない導入

    社内チャットボットの選び方|タイプ別比較と失敗しない導入

    「チャットボット 社内」で検索すると、「おすすめ10選」「14選」「16選」といった製品比較の記事が並びます。ところが、比較表は製品側の違いは教えてくれても、「自社側で何を決めておくべきか」は教えてくれません。決まっていない状態で読み比べると、機能一覧の多さに引きずられて選んでしまい、導入後に「言い回しが違うと答えられない」「誰も使わなくなった」という定番の失敗をなぞることになります。

    **比較表より先に、自社で決める3つのこと**

    – **対応範囲** — 誰の・どの問い合わせに答えさせるか。社内特化か社内外兼用かで、扱う情報の機密度とセキュリティ要件が根本から変わる。
    – **回答方式** — シナリオ型・AI型・RAG型のどれで答えさせるか。3タイプは==「何を参照して答えるか」==が違い、表記ゆれへの強さと運用の手間を決める。
    – **運用体制** — 導入後に誰がFAQ・ナレッジを更新し続けるか。「使われなくなる」失敗の大半は、ツールではなくここで起きる。

    なお、この記事はAIヘルプデスクという仕組みのうち「社内向けチャットボット」の選び方に絞った記事です。仕組み(RAG)や費用相場を含む全体像は親記事の[AIヘルプデスクとは](/blogs/ai-helpdesk)に、FAQ特化型の定義・作り方は[FAQチャットボットとは](/blogs/faq-chatbot)に譲ります。ここでは上の3つを自社で決め切れるように、タイプの地図 → 判断軸 → タイプ別比較 → ケース別の推奨 → 導入手順 → 選定後につまずく所 → 選定フロー、の順で判断材料を置いていきます。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— 社内ナレッジベースを参照して働く司令塔AI社員「Polaris AI」を開発し、自社でも3部門・約20のAIエージェントからなるAI社員組織を内製運用するメンバーが執筆しています

    ## 社内チャットボットの選択肢の地図 — 回答方式で3タイプに分かれる

    社内チャットボットとは、従業員からの問い合わせ(総務・人事・情シス・経理への手続き確認、社内ツールの使い方、規程の所在など)に、チャット形式で自動応答する仕組みです。選択肢を整理する軸は2つあります。1つ目は**回答方式**で、シナリオ型・AI型(FAQ学習型)・RAG型(生成AI型)の3タイプに分かれ、「何を参照して、どう答えるか」が違います。2つ目は**対応範囲**で、社内特化型か社内外兼用型かに分かれ、扱う情報の機密度と必要なセキュリティ設計が違います。製品名を並べる前にこの2軸で自社の要件を言語化しておくと、数十ある候補は自然に数個まで絞れます。

    ![社内チャットボットの選択肢を階層で整理した図。まず回答方式でシナリオ型・AI型・RAG型の3タイプに分かれ、それぞれがさらに対応範囲によって社内特化型と社内外兼用型に分岐することを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig1-hierarchy-chatbot-types.png)

    ### シナリオ型・AI型・RAG型 — 「何を参照して答えるか」の違い

    3タイプの違いは、賢さの優劣ではなく回答の材料の違いです。

    – **シナリオ型**:あらかじめ用意した分岐と一問一答で答えます。想定内の質問には確実に同じ答えを返せる一方、想定外の聞き方には無力です。作る手間と保守の手間は、登録した分岐・Q&Aの数に比例して増えます。
    – **AI型(FAQ学習型)**:登録したFAQをAIが照合・検索して、最も近い答えを提示します。FAQ検索に特化したタイプ(社内FAQ AI)もこの系譜です。シナリオ型より言い換えに強い一方、精度は登録FAQの量と表現のバリエーションに依存します。
    – **RAG型(生成AI型)**:社内文書・FAQ・データベースを検索し、見つけた記述を根拠に生成AIが回答を組み立てます。RAG(Retrieval-Augmented Generation:検索拡張生成)の原典は[Lewisらの2020年の論文](https://arxiv.org/abs/2005.11401)で、平易な解説は[AWSの公式ドキュメント](https://aws.amazon.com/jp/what-is/retrieval-augmented-generation/)にあります。根拠を検索してから答えるため、モデル単体より事実に沿った回答を作りやすい一方、誤答がゼロになるわけではありません。マニュアルや規程の更新を回答へ反映するには、検索インデックスの同期と取得結果の検証も必要です。

    ここでよくある疑問が「RAG型とFAQ型は何が違うのか」です。FAQ型は**登録済みのQ&Aの中から**最も近いものを探して返すのに対し、RAG型は**文書そのものを検索して**答えを組み立てます。つまり、質問が定型的でFAQが整備済みならFAQ型で足り、マニュアル・議事録など文書が厚く聞き方の幅が広いならRAG型が向く、という住み分けです。FAQ特化型の機能・想定質問の作り方は[FAQチャットボットの記事](/blogs/faq-chatbot)で詳しく解説しています。

    ### 対応範囲の分岐 — 社内特化型か、社内外兼用型か

    もう1つの分岐が、社内の従業員だけに使わせるか、Webサイトの顧客対応と兼用するかです。社内特化型は、就業規則・人事手続き・社内システムといった==社内に閉じた情報==を扱う前提で、部署別の権限管理やSlack・Teams連携が設計の中心になります。社内外兼用型は1つの製品で両方をまかなえる効率がある一方、社外向けは誤答が売上・信頼に直結し、社内向けは機密情報の扱いが論点になる、と重視すべきリスクが異なります。「社外向けで実績のある製品だから社内もそのままでよい」とは限らない——これが社内チャットボット選びの出発点です。

    ▶ 関連記事: [AIヘルプデスクとは?仕組み・費用相場・失敗しない選び方を解説](/blogs/ai-helpdesk)

    ## 失敗しない社内チャットボット選びの判断軸 — ナレッジ・安全性・運用・コスト

    冒頭の3つ(対応範囲・回答方式・運用体制)を自社側で決めたら、候補製品は**①ナレッジ接続力 ②セキュリティ・権限管理 ③運用負荷 ④コスト**の4軸で評価します。ベンダーの「おすすめ◯選」記事は機能一覧の横並びが中心で、この4軸のうちセキュリティと運用負荷が後回しにされがちです。しかし社内チャットボットは機密情報を扱い、導入後の運用で成否が決まる仕組みなので、私たちは==セキュリティ・権限管理を選定の入口==に置くことをすすめています。4軸それぞれで「何を確認すればよいか」を順に見ていきます。

    ![社内チャットボット選定の4つの判断軸であるナレッジ接続力・セキュリティ権限管理・運用負荷・コストをレーダーチャートで示し、シナリオ型・AI型・RAG型それぞれの強み弱みのプロファイルが異なることを表した図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig2-radar-selection-axes.png)

    ### ナレッジ接続力 — 既存のFAQ・マニュアルをどう読み込ませるか

    確認するのは「自社にすでにあるナレッジ(FAQ・マニュアル・規程・議事録)を、どんな形式で・どれだけの手間で取り込め、更新がどう反映されるか」です。シナリオ型は取り込みという概念自体がなく、すべて手作業で分岐に翻訳します。AI型はFAQをCSV等で一括登録できるものが多い一方、FAQ化されていない文書は読めません。RAG型はNotion・Google Drive・共有フォルダなどの情報源に接続し文書のまま参照できますが、スキャンPDFや画像ばかりの文書庫では検索の段階で答えが見つかりません。つまりこの軸は、製品の性能評価であると同時に**自社ナレッジの棚卸し**でもあります。接続先となるナレッジ基盤側の整え方は、ナレッジマネジメントツールの記事で深掘りしています。

    ▶ 関連記事: [ナレッジマネジメントツール比較|種類・選び方とAI活用の軸](/blogs/knowledge-management-tools)

    ### セキュリティ・権限管理 — 社内向け特有の要件を選定の入口に

    社内チャットボットは、社外向けと違って人事・労務・経理といった機密性の高い情報に近い場所で動きます。複数のセキュリティ解説([リコー 働き方改革ラボ](https://www.ricoh.co.jp/magazines/workstyle/column/chatbot-security-risk-management/)・[CBT-Solutions](https://cbt-s.com/helpnavi-column/hn0116/))で共通して挙がる確認点は、①**部署・役職に応じたアクセス制御**(誰の質問に、どの文書を根拠にどこまで答えてよいか)②**入力ガイドライン**(従業員が個人情報・機密情報を入力する場面のルール)③**ログの取得・監視**(誰が何を聞き、何が答えられなかったかを追えるか)④**入力内容がAIの学習に使われない設定・契約**——の4点です。この4点は後から直すほど手戻りが大きいため、機能比較の前段で候補を足切りする条件として使うのが安全です。

    ### 運用負荷とコスト — 「誰が更新し続けるか」で総コストが決まる

    見積書に載る月額は、総コストの一部でしかありません。シナリオ型は月額が安くても、分岐・Q&Aの追加修正がすべて手作業のため、対象業務を広げるほど保守工数が線形に増えます。AI型はFAQの追加・言い回しの追補、RAG型は接続先文書の鮮度維持が、それぞれ継続的な運用タスクとして残ります。月額のレンジはタイプでおおよそ決まり(次の章の比較表で示します)、それに「誰が・週に何時間、ナレッジ更新に使えるか」という自社側の工数を足したものが実際のコストです。運用担当を決められないなら、高機能なタイプを選ぶより対象範囲を狭くするほうが、結果的に安く定着します。

    ## タイプ別比較 — 回答方式ごとの強みと前提

    3タイプを4軸で並べると、下の表のようになります。読み方のポイントは、==「高機能なタイプほど正解」ではない==ことです。RAG型はナレッジ接続力で圧倒的ですが、参照させる文書の整備と権限設計という前提コストを要求します。シナリオ型は拡張性に乏しい代わりに、答えを完全に統制でき、月額も安い。つまりこの表は優劣表ではなく、「自社の問い合わせの性質と運用体制に、どの割り切りが合うか」を見るための適合表です。

    | 判断軸 | シナリオ型 | AI型(FAQ学習型) | RAG型(生成AI型) |
    |—|—|—|—|
    | ナレッジ接続力 | ×(手作業で分岐に翻訳) | △(FAQ形式のみ一括登録可) | ◎(文書のまま接続・更新が反映) |
    | 表記ゆれへの強さ | ×(想定外の聞き方に無力) | ○(登録FAQの範囲で対応) | ◎(言い回しが違っても検索で到達) |
    | セキュリティ設計のしやすさ | ◎(答えを完全に統制できる) | ○(FAQ単位で公開範囲を管理) | △(文書単位の権限設計が必須) |
    | 運用負荷 | 保守が手作業・件数に比例 | FAQの追加・言い回し追補が継続 | 接続先文書の鮮度維持が継続 |
    | 月額の報告レンジ(執筆時点) | 数千円〜5万円程度 | 10万〜50万円程度 | 15万〜50万円程度から |

    月額レンジは、[NTT東日本のチャットボット費用解説](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)や[Tayoriの料金相場記事](https://tayori.com/blog/ai-chatbot-pricing/)など複数メディアの報告値を執筆時点(2026年7月)で突き合わせた目安です。問い合わせ件数・利用人数・設置チャネル数・生成AIの従量課金で大きく動くため、単一の相場としては扱わず、見積もりでは「その金額にFAQ・ナレッジ整備の支援が含まれるか」を必ず確認してください。費用の内訳と費用対効果の考え方は[親記事](/blogs/ai-helpdesk)で詳しく扱っています。

    ![シナリオ型・AI型・RAG型の3タイプをナレッジ接続力・表記ゆれ対応・セキュリティ設計・運用負荷の4軸で評価し、強弱を濃淡で示したヒートマップ。タイプごとに強い軸が異なり万能なタイプは存在しないことを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig3-heatmap-type-axis.png)

    ## ケース別のおすすめ — こんな会社にはこのタイプ

    自社がどのケースに近いかで、起点にするタイプは変わります。目安はシンプルで、**問い合わせの定型度が高いほど軽いタイプで足り、ナレッジ(文書)が厚く聞き方の幅が広いほどRAG型が効きます**。そして、どのタイプでも運用リソースが確保できないなら、対象範囲を狭めるか外部の伴走を前提にします。以下、従業員30〜100名規模の会社で私たちがよく相談を受ける3つのケースに当てはめます。

    ### 定型的な問い合わせが多い総務・人事 — シナリオ型/FAQ学習型でスモールスタート

    「年末調整の書類はどこ」「経費精算の締めはいつ」「入社手続きの案内」など、聞かれることがほぼ決まっていて答えが短い部署なら、シナリオ型かAI型(FAQ学習型)で十分に効果が出ます。よくある問い合わせの上位20〜30件をFAQ化して登録し、社内ポータルやSlackの目立つ場所に置くだけで、一次対応のかなりの部分を置き換えられます。ここで重要なのは対象を絞ることです。最初から全部署・全業務をカバーしようとすると登録と保守が破綻します。まず1部署で「答えられる率」を上げ、未回答ログを見ながら広げるのが定石です。

    ### マニュアル・議事録が厚く、表記ゆれが多い — RAG型が向く

    情シスへの技術的な質問、業務マニュアルの参照、過去の決定事項の確認など、答えが文書の中に埋まっていて、聞き方が人によってバラバラな環境では、FAQ登録型はすぐ限界が来ます。「VPNがつながらない」「リモート接続できない」「社外から入れない」を同じ質問だと束ねるには、FAQの言い換え登録を延々と続けるか、文書を直接検索するRAG型に任せるかの二択です。文書資産がすでに厚い会社ほどRAG型の投資対効果は高くなりますが、前提として「その文書がAIから読めるテキストで存在するか」「部署別の参照権限を設計できるか」を先に確認してください。

    ### 情シス不在・少人数で運用リソースが割けない — 軽いタイプ+外部の伴走

    専任の情シスがおらず、総務やITに詳しいメンバーが兼任している会社では、「導入はできたが運用が回らない」が最頻の失敗です。この場合の選択肢は2つです。1つは、対象をごく狭く絞った軽いタイプ(シナリオ型・FAQ学習型)で始め、月1回のFAQ棚卸しだけをルール化する道。もう1つは、ナレッジの整備・更新体制の設計まで含めて外部パートナーと組む道です。避けるべきは、運用体制のないままRAG型など重いタイプを入れることです。高機能なツールは参照先が古びるほど誤答が目立ち、かえって信頼を失う速度が上がります。

    ![自社の状況から社内チャットボットのタイプを絞り込むためのチェックカード。問い合わせの定型度・文書資産の厚さ・表記ゆれの多さ・運用担当の有無などの項目に当てはまるかどうかで、シナリオ型・FAQ学習型・RAG型のどれを起点にするかを判定する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig4-checklist-case-fit.png)

    ## 選定後の導入手順 — 棚卸しから本番運用までの4ステップ

    タイプと候補製品を絞った後は、①問い合わせの棚卸し ②FAQ・マニュアルの整備と登録 ③小さな試験運用 ④本番運用とエスカレーション設計、の4ステップで進めます。重要なのは、契約や設定を起点にしないことです。最初に実際の問い合わせログを集め、答えの根拠となる文書と更新責任者を決めてからツールへ登録します。試験運用では、普段その業務に詳しくないメンバーも含めて質問してもらい、回答できなかった質問と的外れな回答を記録します。本番公開時は、AIに答えさせない領域と人への引き継ぎ先を明文化し、未回答ログの確認を定常業務へ組み込んでください。

    ![社内チャットボット構築の4ステップを示したフロー図。想定問い合わせの棚卸しと分類、FAQ・マニュアルの整備とAIへの登録、小さく試験運用、本番運用開始とエスカレーション設計の流れを、各ステップのつまずき所とともに示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig3-steps-build-process.png)

    1. **問い合わせを棚卸しする**:直近2〜3か月のメール・チャット・対応履歴から、頻度が高く答えを定型化できる質問を集めます。最初の対象は1部署・上位20〜30問ほどに絞ります。
    2. **FAQ・マニュアルを整備する**:古い規程や廃止済み手順を除き、文書ごとに更新責任者を決めます。シナリオ型・AI型なら1問1答、RAG型ならAIが読めるテキストと適切な文書単位を用意します。
    3. **小さく試験運用する**:対象部署を限定し、回答到達率・誤答・有人への引き継ぎ率を確認します。同じ部署だけで試すと言い回しが偏るため、別部署のメンバーにも使ってもらいます。
    4. **本番運用と引き継ぎを設計する**:人事評価・個別の労務相談などAIに答えさせない領域を決め、解決できない質問の引き継ぎ先を示します。公開後は未回答ログを月次で見直し、FAQ・文書を更新します。

    ## 選定後につまずく所 — 「導入して終わり」にしない

    社内チャットボット選びの失敗は、契約時ではなく導入の2〜3か月後に表面化します。しかも症状は「精度が低い」ではなく「誰も使っていない」という形で現れることが多く、原因をツールに求めて乗り換えを検討し、同じ失敗を繰り返すケースが後を絶ちません。ここでは、複数の実務解説で一致している失敗要因と、私たちが自社運用の経験から選定段階で確認している見極めを示します。この章が、比較表よりも導入の成否を左右します。

    ### 複数の実務解説で共通する4つの失敗要因

    社内チャットボットの失敗要因は、複数の実務解説([AGS](https://www.ags.co.jp/column/ai-column17.html)・[リコー 働き方改革ラボ](https://www.ricoh.co.jp/magazines/workstyle/column/chatbot-increase-usage-strategy/)・[OfficeBot](https://officebot.jp/columns/business-efficiency/chatbot-failure-cases/)・[Helpfeel](https://www.helpfeel.com/blog/chatbot-failure-reason))でほぼ同じ4点に収れんしています。①**認知度不足**:存在が知られず、従業員が従来どおり人に聞く。②**FAQ・ナレッジの陳腐化**:未回答ログを見ずに放置し、答えられない質問が増えて信頼を失う。③**運用リソース不足**:専任を置かず兼任にした結果、フィードバック対応が止まる。④**導入目的の不明確さ**:どの問い合わせを減らすのかを決めずに導入し、効果を測れない。注目すべきは、4つとも製品の機能とは無関係だということです。だからこそ、これらは選定の段階で──つまり導入前に──体制として潰しておけます。

    ![社内チャットボットの運用状態を「機能する・条件つき・形骸化する」の3段階の信号で示した図。ナレッジの更新・未回答ログのレビュー・社内での認知の3項目それぞれについて、健全な状態と形骸化のサインを対比する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig5-signal-pitfalls.png)

    ### 私たちの見極め — 「導入後もナレッジが更新され続ける体制か」

    私たちPolarisXは、司令塔AI社員「Polaris AI」を提供する側であると同時に、自社でも3部門・約20のAIエージェントが同じ社内ナレッジベースを共有脳として参照する形で内製運用しています。この運用で繰り返し確認しているのは、AIの回答品質が目に見えて変わるのは「ツールを替えたとき」ではなく「参照先のナレッジを直したとき」だという事実です。だから選定の最終確認として私たちが使う問いは1つです。「**この製品を入れたあと、誰が・どんなきっかけで・どれくらいの頻度でナレッジを更新するか、いま答えられるか**」。未回答ログを月次でレビューする担当と時間を決められないなら、どのタイプを選んでも結果は変わりません。

    失敗の判定基準も先に決めておきましょう。==導入3か月後に、FAQ・マニュアルの更新履歴が止まっていたら==、それはツールの性能ではなく運用体制が形骸化しているサインです。このときの正しい打ち手は乗り換えの検討ではなく、未回答ログを見てナレッジを直すことです。逆に、更新は回っているのに解決率が上がらないなら、そこで初めてタイプ選定(シナリオ型の限界・RAG型への移行)を疑ってください。

    **候補を絞り込む前に、「自社のナレッジと運用体制がチャットボットに耐えるか」から確かめたい方へ** — PolarisXは、社内ナレッジベースの構築と、それを参照して働く司令塔AI社員「Polaris AI」を提供しています。ツール選定の前段にあるナレッジの棚卸し・更新体制の設計からご一緒します。無料相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ## 選定フロー

    最後に、ここまでの判断軸を1本の流れにつなぎます。上から順に答えていけば、起点にすべきタイプと、その前にやるべきことが決まります。

    1. **社外の顧客対応と兼用するか?** — 兼用するなら社内外兼用型の中で、社内側の権限管理ができる製品に絞る。社内専用なら次へ。
    2. **機密情報の扱いを設計できるか?** — 部署別アクセス制御・学習不使用の設定・ログ監視の4条件(判断軸の章)で候補を足切りする。ここを満たさない製品は機能が良くても外す。
    3. **問い合わせは定型的で、FAQはすでにあるか?** — Yesなら、シナリオ型かAI型(FAQ学習型)でスモールスタート。対象は1部署・上位20〜30問から。
    4. **文書資産が厚く、聞き方の幅が広いか?** — Yesなら、RAG型を検討。ただし「文書がAIから読めるテキストで存在するか」を先に棚卸しする。読めないなら、ナレッジ整備が先。
    5. **ナレッジの更新担当と頻度を、いま決められるか?** — 決められるならそのまま導入へ。決められないなら、対象範囲をさらに絞るか、運用の伴走まで含めて外部と組む。

    ![社内チャットボットの選定フローチャート。社外対応との兼用有無、セキュリティ要件の充足、問い合わせの定型度とFAQの有無、文書資産の厚さ、運用体制の確保という5つの分岐を順にたどり、シナリオ型・FAQ学習型・RAG型のどれを起点にするか、または先にナレッジ整備を行うべきかを判定する決定木](https://cms.polarisx.ltd/wp-content/uploads/2026/08/internal-chatbot-fig6-decision-selection-flow.png)

    このフローの分岐の多くが、製品ではなく自社側の状態(ナレッジと体制)を問うていることに気づくはずです。社内チャットボットのために整えたFAQ・マニュアルは、問い合わせ対応の専用資産ではありません。同じナレッジベースを資料作成・引き継ぎ・オンボーディングなど他の業務を担うAIの共有脳として使い回す——私たちが「AI社員」と呼ぶ働き方は、この延長線上にあります。

    ▶ 関連記事: [AI社員とは?意味・違い・費用と中小企業の導入判断を解説](/blogs/ai-employee)

    ## よくある質問

    **Q. 社内チャットボットとは何ですか?社外向けと何が違いますか?**
    社内チャットボットとは、従業員からの問い合わせ(総務・人事・情シスへの手続き確認や社内ツールの質問など)にチャット形式で自動応答する仕組みです。社外向けとの最大の違いは、就業規則・人事情報など社内に閉じた機密情報を扱う前提にあることで、部署別のアクセス制御・入力内容が学習に使われない設定・ログ監視といったセキュリティ要件が選定の入口になります。

    **Q. RAG型チャットボットとFAQ型チャットボットは何が違いますか?**
    FAQ型は登録済みのQ&Aの中から質問に最も近いものを探して返すのに対し、RAG型は社内文書そのものを検索し、見つけた記述を根拠に生成AIが回答を組み立てます。質問が定型的でFAQが整備済みならFAQ型で足り、マニュアル・議事録など文書が厚く聞き方の幅が広いならRAG型が向きます。RAG型は文書を更新すれば回答も追随する一方、参照する文書の整備と権限設計が前提になります。

    **Q. 社内チャットボットのセキュリティ対策は何が必要ですか?**
    確認すべきは4点です。①部署・役職に応じたアクセス制御(誰の質問にどの文書を根拠にどこまで答えるか)②従業員が個人情報・機密情報を入力する場面のガイドライン ③質問と回答のログの取得・監視 ④入力内容がAIの学習に使われない設定・契約。いずれも後から直すほど手戻りが大きいため、機能比較の前に候補を足切りする条件として使うのが安全です。

    **Q. 社内チャットボットはなぜ使われなくなる・定着しないのですか?**
    よくある要因は、①存在が知られていない ②未回答ログを見ずにFAQ・ナレッジが陳腐化する ③運用担当を置かず改善が止まる ④減らしたい問い合わせが不明確、の4つです。まず「誰が・どんなきっかけで・どれくらいの頻度でナレッジを更新するか」を決めてください。更新が回っているのに改善しない場合は、検索・回答生成・権限・外部連携など技術側の原因をログで切り分けます。

    **Q. どのタイプの社内チャットボットが自社に向いていますか?**
    問い合わせの定型度とナレッジの厚さで決まります。聞かれることがほぼ決まっている総務・人事の手続き系なら、シナリオ型かFAQ学習型で1部署からのスモールスタートが確実です。マニュアル・議事録が厚く聞き方の幅が広いならRAG型が向きますが、文書がAIから読めるテキストで存在することが前提です。運用リソースを確保できない場合は、高機能なタイプより対象範囲を絞った軽いタイプ、または外部の伴走を選んでください。

    **社内の問い合わせ対応を「自社に残る形」で自動化したい方へ** — PolarisXは、①法人向けAIエージェントの開発 ②社内ナレッジベースの構築 ③AIコンサルティングサービスを提供する会社です。自社でも3部門・約20のAIエージェントを内製運用する当事者として、チャットボットのタイプ選定からナレッジ整備・更新体制の設計までをご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧ください。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社AI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。社内ナレッジベースをAIの共有脳として日々運用する立場から、本記事は製品の機能比較に寄りがちな選び方の議論に「何を参照して答えるか」「誰が更新し続けるか」という実務の判断基準を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(Lewis et al., 2020)](https://arxiv.org/abs/2005.11401)
    – [RAG(検索拡張生成)とは何ですか?(AWS 公式ドキュメント)](https://aws.amazon.com/jp/what-is/retrieval-augmented-generation/)
    – [チャットボットの費用はいくら?初期費用・月額料金の相場から費用対効果の算出方法まで徹底解説(NTT東日本)](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)
    – [AIチャットボットの料金相場は?初期費用・月額費用・タイプ別比較を徹底解説【2026年版】(Tayori Blog・2026年)](https://tayori.com/blog/ai-chatbot-pricing/)
    – [チャットボットのセキュリティ対策は万全?安全な選び方を解説(リコー 働き方改革ラボ)](https://www.ricoh.co.jp/magazines/workstyle/column/chatbot-security-risk-management/)
    – [チャットボットのセキュリティ対策5選|AI導入の注意点も解説(CBT-Solutions)](https://cbt-s.com/helpnavi-column/hn0116/)
    – [社内チャットボットで失敗しないためには?導入前に知るべき原因と対策(AGS株式会社)](https://www.ags.co.jp/column/ai-column17.html)
    – [チャットボットが使ってもらえない!失敗原因と具体的な解決策を解説(リコー 働き方改革ラボ)](https://www.ricoh.co.jp/magazines/workstyle/column/chatbot-increase-usage-strategy/)
    – [チャットボットは使えない?失敗した企業の事例と失敗した理由を解説(OfficeBot 生成AI社内活用ナビ)](https://officebot.jp/columns/business-efficiency/chatbot-failure-cases/)
    – [チャットボットは役に立たない?失敗の原因や改善策・成功事例も紹介(Helpfeel)](https://www.helpfeel.com/blog/chatbot-failure-reason)

  • FAQチャットボットとは?仕組み・違い・費用相場・作り方を解説

    FAQチャットボットとは?仕組み・違い・費用相場・作り方を解説

    FAQチャットボットとは、「パスワードの再設定方法は?」「送料はいくら?」といったよくある質問(FAQ)への回答を、あらかじめ用意したQ&Aデータや社内文書をもとにチャット形式で自動応答する仕組みのことです。Webサイトの隅に表示される質問窓や、社内のSlack・Teamsで手続きを教えてくれるボットが典型で、問い合わせ対応の一次窓口を人の代わりに担います。

    なお、この記事はAIヘルプデスクという仕組み全体のうち「FAQチャットボット」という部品に焦点を絞った解説です。有人への引き継ぎや運用改善まで含む仕組み全体の話は親記事の[AIヘルプデスクとは](/blogs/ai-helpdesk)に、SlackやTeamsなど社内チャネルへ組み込む手順は[社内チャットボットの作り方](/blogs/internal-chatbot)に譲ります。

    この言葉の周りが分かりにくいのは、検索して出てくる情報の型がバラバラだからです。「FAQシステムとの違い」を説くページ、「チャットボット用FAQの作り方」を語るページ、ツールを並べる「おすすめ◯選」が混ざり合い、しかも多くはツールの紹介で終わります。一方で導入した側の悩みは、その先にあります。「FAQを登録したのに、聞き方が少し違うと答えられない」「作ったはいいが、更新が止まって使われなくなった」。この記事は、定義・タイプ・混同されがちな概念との違い・メリット・作り方の考え方・費用相場・精度が上がらない理由までを一続きで整理し、読み終わった時点で「自社に向くか、何から準備するか」を判断できる状態を目指します。

    > **一言でいうと**:FAQチャットボットとは、よくある質問への回答をチャット形式で自動応答する仕組みです。回答精度を決めるのはツール選びそのもの以上に、==FAQデータの整備と更新==——質問と答えの組をどれだけ揃え、言い回しを補い、直し続けられるか——です。
    >
    > **先に正しておきたい誤解3つ**
    > 1. **FAQを登録すれば、どんな聞き方にも答えられる** — タイプによって言い回しの違いへの強さは大きく異なります。シナリオ型は想定した分岐から外れた質問には答えられません。
    > 2. **FAQページを置くのと同じ** — 探し方が違います。FAQページは利用者が自分で検索して探す仕組み、チャットボットは対話で答えまで導く仕組みで、向いている質問も異なります。
    > 3. **一度作れば手を離せる** — FAQデータは業務の変化とともに古くなります。更新が止まったボットは誤答と「答えられません」が増え、使われなくなります。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— FAQを含む社内ナレッジベースを共有脳として、3部門・約20のAIエージェントからなるAI社員組織を内製運用するメンバーが執筆しています。

    ## FAQチャットボットとは — よくある質問をチャット形式で自動応答する仕組み

    FAQチャットボットとは、よくある質問(FAQ)への回答を、チャット形式の対話で自動応答する仕組みです。利用者が質問文を入力するか選択肢を選ぶと、ボットがあらかじめ登録されたQ&Aデータや社内文書から該当する答えを見つけて返します。設置場所はWebサイトのサポート窓口、社内ポータル、Slack・Teamsなどのビジネスチャットが代表的で、社外の顧客対応にも、情シス・総務への社内問い合わせにも使われます。人の担当者と違って24時間応答でき、同じ質問には何度でも同じ品質で答えられる一方、答えの材料となるFAQデータが存在しない質問には答えられません。つまりFAQチャットボットの実体は「ボット」と「FAQデータ」の2つで構成されていて、導入の成否は後者に大きく左右されます。

    ![FAQチャットボットの3タイプを分類ツリーで示した図。回答の作り方を軸に、シナリオ型(設計済みの分岐を選択肢でたどる)、FAQ検索型(登録済みFAQと質問文を照合して提示する)、生成AI・RAG型(FAQや文書を検索して回答文を生成する)に分かれ、後者ほど言い回しの違いに強くなることを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig1-tree-types.png)

    ### 3つのタイプ — シナリオ型・FAQ検索型・生成AI・RAG型

    FAQチャットボットは、答えの返し方で3タイプに分かれます。

    | タイプ | 答えの返し方 | 言い回しの違いへの強さ |
    |—|—|—|
    | **シナリオ型** | あらかじめ設計した分岐を、利用者が選択肢でたどる | 弱い(設計した分岐の範囲のみ) |
    | **FAQ検索型(AI搭載)** | 入力された質問文を登録済みFAQと照合し、該当するQ&Aを提示する | 中程度(類義語辞書・学習の範囲) |
    | **生成AI・RAG型** | ChatGPTに代表される生成AIが、FAQ・社内文書を検索して回答文を生成する | 強い(文意で照合できる) |

    シナリオ型は、質問の種類が少なく分岐で網羅できる場面(営業時間・返品手順など)では確実に動き、費用も抑えられます。FAQ検索型は登録したFAQの範囲で自由入力に答えられますが、登録した表現と利用者の表現がずれると取りこぼします。生成AI・RAG型は==言い回しの違いに最も強い==タイプで、文書から該当箇所を探して答えを組み立てられますが、参照する文書・FAQが薄いともっともらしい誤答(ハルシネーション)のリスクを抱えます。どのタイプでも「FAQデータが答えの上限を決める」構図は変わりません。

    ### なぜ「チャット」という形式が選ばれるのか

    FAQページとの本質的な違いは、答えへの到達のしかたです。FAQページでは、利用者が一覧をスクロールするか検索窓に言葉を入れて、自分で答えを探します。適切な検索語を思いつけない人、そもそもどのカテゴリを見ればよいか分からない人は、答えがページ内に存在していても辿り着けません。チャット形式は、質問をそのまま書けば(あるいは選択肢を選ぶだけで)ボット側が絞り込んでくれるため、探すスキルを利用者に要求しません。スマートフォンの小さい画面でも操作しやすく、「こんな初歩的なことを人に聞きづらい」という心理的ハードルも下げます。一方で、チャットの吹き出しは一度に見せられる情報量が少ないため、長い手順書や図表を読ませたい内容には向きません。この向き不向きが、次章の「FAQシステムとの違い・使い分け」につながります。

    ## チャットボット・FAQシステム・AIヘルプデスクは何が違うのか

    FAQページ(FAQシステム)・FAQチャットボット・AIヘルプデスクの3つは、「同じFAQデータをどう届けるか」と「対応範囲をどこまで持つか」の2つの観点で整理すると混同がほどけます。FAQページ・FAQシステムは、利用者が自分で検索して答えを探すための仕組みです。FAQチャットボットは、同じFAQデータを対話形式で届け、答えまで導く仕組みです。そしてAIヘルプデスクは、これらを部品として含み、有人への引き継ぎ(エスカレーション)や問い合わせログをもとにした運用改善までを担う、問い合わせ対応の仕組み全体を指します。つまり3つは「どれを選ぶか」の並列な選択肢ではなく、届け方の違い(ページかチャットか)と、範囲の違い(部品か仕組み全体か)という別々の軸で位置づけられる関係です。

    ![FAQページ・FAQシステム・FAQチャットボット・AIヘルプデスクの位置づけを、対応範囲の広さと対話性の2軸マップで示した図。FAQページとFAQシステムは検索型で対応範囲が狭い側に、FAQチャットボットは対話型の部品として中央に、AIヘルプデスクは有人引き継ぎや運用改善まで含む対応範囲が最も広い位置に置かれる](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig2-matrix-scope.png)

    ### FAQページ・FAQシステムとの違い — 検索か、対話か

    両者の違いは優劣ではなく、==探し方(検索か対話か)==と向いている質問の違いです。

    | 観点 | FAQページ・FAQシステム | FAQチャットボット |
    |—|—|—|
    | 答えへの到達 | 一覧・検索窓から利用者が自分で探す | 質問を入力すると対話で絞り込まれる |
    | 一度に示せる情報量 | 長文・図表・動画をページで見せられる | 吹き出しの短文が中心 |
    | 向いている質問 | 手順が長い内容・網羅的に読ませたい内容 | 答えが短く決まる定型質問 |
    | 更新の単位 | ページ・記事ごと | 1問1答のFAQデータ+言い換え表現 |

    実務では二者択一ではなく併用が基本です。定型の短い質問はチャットボットが即答し、手順が長い質問は該当するFAQページへリンクで誘導し、どちらでも解決しなければ有人窓口へつなぐ——という多段の設計にすると、それぞれの弱点を補い合えます。逆に、長大なマニュアルの内容を全部チャットボットに答えさせようとする設計は、吹き出しに収まらない切れ切れの回答を生み、かえって体験を悪くします。

    ### AIヘルプデスクとの関係 — FAQチャットボットは「一次応答の部品」

    AIヘルプデスク全体から見ると、FAQチャットボットは入口に置かれる一次応答の部品です。仕組み全体には、この部品に加えて、答えられなかった質問を誰にどう引き継ぐか(エスカレーション設計)、問い合わせログをどうFAQの改善に還元するか(運用改善)、どの文書をAIの参照範囲に入れるか(ナレッジとセキュリティの設計)が含まれます。部品単体を置いただけの導入が形骸化しやすい理由、仕組み全体の費用相場や導入判断は、親記事で詳しく整理しています。

    ▶ 関連記事: [AIヘルプデスクとは?仕組み・費用相場・失敗しない選び方を解説](/blogs/ai-helpdesk)

    ## メリットと効く場面 — どんな問い合わせに向くのか

    FAQチャットボットのメリットは大きく4つあります。①営業時間外や休日でも即答できる(24時間365日対応)②同じ答えを人が繰り返す一次対応の工数を減らせる ③回答が登録データにもとづくため、担当者による品質のばらつきがなくなる ④「誰が・何を・どう聞いたか」の質問ログが残り、FAQの穴が見えるようになる——の4つです。ただし、この効果は問い合わせの種類を選びます。効果が集中して出るのは、同じ質問が繰り返し届いていて、答えを短い文章に決められる領域です。逆に、個別の状況判断が必要な相談ごとに置いても効果は出ません。導入判断の実務は「全問い合わせのうち、定型の質問が何割か」を数えることから始まります。

    ### 4つのメリット — 特に見逃されがちな「質問ログ」

    前の3つ(24時間対応・工数削減・品質の均一化)は多くの解説記事が挙げるとおりですが、実務でいちばん価値が見逃されがちなのは4つ目の質問ログです。有人対応では、問い合わせは個人のメールやチャットに散らばり、「どんな質問が多いのか」を集計すること自体に手間がかかります。チャットボットを一次窓口にすると、質問が1箇所に記録され、答えられなかった質問(未回答ログ)まで残ります。この未回答ログは、言い換えれば==社内にまだ文書化されていない知識のリスト==です。FAQの追記先を推測ではなくデータで決められるようになることは、工数削減と並ぶ、独立したメリットとして数えてよいものです。

    ### 効果が出やすい問い合わせ・出にくい問い合わせ

    効果が出やすいのは、==定型的で、答えを文書化できる質問==です。パスワード再設定、経費精算・勤怠の手続き、送料・納期・対応環境といった仕様の質問、社内ツールの初歩的な使い方が典型です。反対に効果が出にくいのは、個別の状況判断や交渉を含む相談(例外対応の可否・金額の調整)、感情面のケアが重要なクレーム、前例のない障害の申告です。これらは最初から人が受ける設計にし、ボットには「どの窓口に伝えるべきか」の交通整理だけを任せます。判断の物差しは「定型度(同じ質問が繰り返されるか)」と「判断の複雑さ(答えるのに個別の事情が要るか)」の2軸で、定型度が高く判断が単純な領域から任せるのが定石です。

    ![問い合わせを定型度と判断の複雑さの2軸で散布図にプロットした図。パスワード再設定や手続き確認など定型度が高く判断が単純な質問が集まる領域をFAQチャットボットの効果が出やすいゾーンとして示し、個別判断を要する相談やクレームは人が受けるべき領域として区別する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig3-scatter-fit.png)

    ## FAQチャットボットの作り方(概要)と費用相場

    作り方の骨組みは、①導入目的を絞る ②想定質問を洗い出す ③ボットが読み取れる形式に整える ④テスト運用して直す——の4ステップです。費用は、執筆時点(2026年7月)の複数メディアの報告値を突き合わせると、シナリオ型で月額数千円〜5万円程度、FAQ検索型(AI搭載)で月額10万〜50万円程度、生成AI・RAG型で月額15万〜50万円程度から、というレンジが目安になります。単一の「相場◯円」は存在せず、金額は質問数・利用人数・チャネル数・FAQ整備支援の有無で大きく動きます。この章では、4ステップの中で精度を左右する勘所と、費用の読み方を順に整理します。なお、SlackやTeamsへの組み込みなど実装レベルの手順は本記事の範囲を超えるため、考え方までを扱います。

    ![チャットボット用FAQ作成の4ステップをフェーズの帯で示したロードマップ図。目的の明確化、想定質問の洗い出し、ボットが読み取れる形式への整形、テスト運用と追加修正の順に進み、整形とテスト運用のフェーズが回答精度を左右する山場であること、ツール契約の費用は整形フェーズ以降に発生することを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig4-roadmap-build-cost.png)

    ### 作り方の4ステップ — 精度は③と④で決まる

    1. **導入目的を絞る**:「どの領域の、どの問い合わせを減らすか」を1つに決めます。範囲を広げるほどFAQ整備の負担が膨らむため、最初は「社内のIT関連の定型質問」のように領域を限定します。
    2. **想定質問を洗い出す**:過去の問い合わせメール・チャット履歴・対応記録から、実際に届いた質問の上位20〜30件を集めます。頭の中の想像で作った質問リストは、現場の聞き方とずれるため精度が出ません。
    3. **ボットが読み取れる形式に整える**:1つの質問に1つの答えを対応させ(1問1答)、同じ質問の==言い換えバリエーション==(「ログインできない」「パスワード忘れた」「入れない」)を質問側に登録します。答えの文章は吹き出しで読める長さに切り、専門用語は現場が実際に使う言葉に合わせます。
    4. **テスト運用して直す**:小さい範囲で公開し、未回答ログ・的外れな回答のログを見てFAQを追記・修正するサイクルを回します。最初の1〜2か月はこの修正が集中する期間として計画に織り込みます。

    多くの導入が②まで、つまり「FAQを集めて登録する」ところで力尽きます。しかし回答精度を実際に決めるのは、③の言い換え整備と④の修正サイクルです。ここに人と時間を割り当てない計画は、タイプやツールの選定がどれほど適切でも精度が頭打ちになります。

    ### 費用相場【執筆時点の報告値】— 金額より「何が含まれるか」

    | タイプ | 月額の報告レンジ(執筆時点の目安) | 初期費用の傾向 |
    |—|—|—|
    | シナリオ型 | 数千円〜5万円程度 | 無料〜10万円程度の報告が中心 |
    | FAQ検索型(AI搭載) | 10万〜50万円程度 | 数十万円規模の報告も |
    | 生成AI・RAG型 | 15万〜50万円程度から | FAQ・文書整備の支援費が加わる場合あり |

    このレンジは、[NTT東日本の費用解説](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)・[Tayoriの料金相場記事](https://tayori.com/blog/ai-chatbot-pricing/)・[ディーエスブランドの費用相場記事](https://ds-b.jp/dsmagazine/chatbot-cost/)など複数メディアの報告値を突き合わせた目安です。参考として、[BOXILの主要26サービス調査](https://boxil.jp/mag/a8292/)では、公開料金をもとに==月額24,000円==という相場も示されています。ただし低価格帯を含む横断集計で、AI・RAG型だけの相場ではありません。いずれも改定・条件で動くため、契約時は必ず個別見積もりで確認してください。

    見積もりを比べるときに金額と同じ重みで確認したいのが、「初期のFAQ整備・言い換え登録・チューニングの支援が範囲に含まれるか」です。前述のとおり精度はFAQデータ側で決まるため、ツール利用料が安くてもFAQ整備がすべて自社任せなら、社内の工数という見えない費用が乗ります。逆に整備支援込みの価格なら、表面上の月額が高くても総コストでは逆転することがあります。

    ## 回答精度が上がらないのはなぜか — 導入しても効かない場面と限界

    FAQチャットボットの回答精度が上がらない・質問に対応できないときは、まずFAQデータを確認します。運用系の解説で繰り返し挙がるのは、①登録FAQの量・範囲が足りない ②言い回し・表記ゆれに対応できていない ③制度改定・組織変更後も古い回答が残っている、の3点です([リコーの正答率解説](https://promo.digital.ricoh.com/chatbot/column/detail180/)など)。ただし、原因はデータだけとは限りません。正しい回答が存在するのに検索・照合で取得できない、取得した根拠から回答を正しく生成できない、権限や外部連携の設定で処理が止まる場合もあります。==データ、検索、生成、権限・連携の順に切り分ける==ことで、FAQの修正で足りるのか、設定変更やツールの見直しが必要なのかを判断できます。

    ![FAQデータの整備度を情報量・更新頻度・言い回しの網羅・専門用語対応の4軸レーダーチャートで示した図。4軸がバランスよく広がった多角形を回答精度が機能する状態、情報量だけ大きく更新頻度と言い回しの網羅がへこんだ多角形を導入直後は動くがやがて形骸化する状態として対比する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig5-radar-precision-axes.png)

    ### 精度を決める4つの軸 — 量・鮮度・言い回し・用語

    FAQデータの整備度は、4つの軸で点検できます。第一に**情報量**:利用者が実際に聞く質問の上位が、どれだけFAQとして存在するか。第二に**更新頻度**:制度・料金・手順が変わったとき、FAQが追随しているか。第三に**言い回しの網羅**:1つの質問に対して、現場が実際に使う複数の聞き方が登録されているか。第四に**専門用語への対応**:社内の略語・自社製品の呼び名など、一般的な辞書にない言葉を教えてあるか。導入直後に動いていたボットが数か月で使われなくなるケースの多くは、第一軸(量)だけを揃えて公開し、第二・第三軸の手当てを運用計画に入れていなかったパターンです。量は一度の努力で揃えられますが、鮮度と言い回しは==継続的な運用でしか維持できません==。

    ### FAQデータ運用でよくあるつまずきと、私たちの見極め基準

    私たちPolarisXは、司令塔AI社員「Polaris AI」を提供する側であると同時に、自社でも3部門・約20のAIエージェントに業務を任せ、FAQを含む社内ナレッジベースをその共有脳として運用しています。その運用で繰り返し経験しているのは、AIの回答がずれたとき、原因をさかのぼると行き着く先はほぼ毎回「参照先に書かれていない・古い・現場の言葉と違う言葉で書かれている」のいずれかだ、ということです。逆に、参照するドキュメントの言い回しを現場の言葉に直し、古い記述を更新しただけで、ツールには一切手を入れずに回答が改善する場面を何度も見てきました。

    だから、私たちが最初に使う見極めの基準は2つです。ひとつは**言い回しの網羅**:FAQの質問文が「作った人の言葉」ではなく「聞く人の言葉」で書かれ、実際の問い合わせログから聞き方を書き足す運用があるか。もうひとつは**更新の習慣**:月1回でも、未回答ログを見てFAQを直す担当者と時間が確保されているか。この2つが欠けた導入は、初期の登録量が多くても、業務の変化に追随できません。

    失敗のサインも先に決めておけます。運用開始から2〜3か月たっても、同じ質問に的外れな回答が繰り返される、あるいは有人への引き継ぎ件数が減らないなら、直近のログを使って原因を調べる段階です。まず①正しい回答が存在し、更新されているか、次に②検索・照合でその回答を取得できているか、③取得した根拠から回答を正しく生成できているか、④権限・連携エラーがないかを確認します。①ならFAQの追記・更新、②〜④なら検索設定・回答制御・連携の調整を検討し、原因を確認してからツールの見直し要否を判断します。

    ▶ 関連記事: [ナレッジマネジメントツール比較|種類・選び方とAI活用の軸](/blogs/knowledge-management-tools)

    **「うちのFAQデータは、チャットボットに耐えられる状態か」から確認したい方へ** — PolarisXは、FAQを含む社内ナレッジベースの構築と、それを参照して働く司令塔AI社員「Polaris AI」を提供しています。ツール選定の前段にある「FAQの棚卸しと、更新が続く運用設計」からご一緒します。無料相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ## 実務での見極め — 選び方と、自社に必要かの判断

    FAQチャットボットを選ぶときの評価軸は、①言い換え対応の強さ ②FAQ更新のしやすさ ③未回答ログ・利用状況の分析機能 ④有人への引き継ぎ設計 ⑤社内ナレッジベースとの接続可否——の5つです。デモで見栄えのする①だけで選ばれがちですが、前章のとおり精度を維持するのは運用なので、運用を支える②と③を同じ重みで確認します。そして、そもそも自社に必要かの判断は「定型の問い合わせが繰り返し届いていて、答えを文書化できるか」で決まります。月に数十件以上の定型質問がある部署なら効果が見込めます。逆に問い合わせが少量で毎回内容が違うなら、ボットを維持する手間が効果を上回るため、まず問い合わせの記録とFAQの文書化から始めるのが合理的です。

    ![FAQチャットボット選定チェックリストの図。言い換え対応の強さ、担当者だけでFAQを更新できるか、未回答ログの分析機能、有人への引き継ぎ設計、社内ナレッジベースとの接続可否の5項目を、確認欄つきの記入枠で並べたもの](https://cms.polarisx.ltd/wp-content/uploads/2026/08/faq-chatbot-fig6-checklist-selection.png)

    ### 選ぶときに見るべき5つの評価軸

    1. **言い換え対応の強さ**:類義語・表記ゆれをどう吸収するか(類義語辞書か、生成AIによる文意の照合か)。自社の問い合わせの「聞き方の散らばり」が大きいほど重要です。
    2. **FAQ更新のしやすさ**:エンジニアを介さず、現場の担当者が管理画面やExcelでFAQを追記・修正できるか。更新の手間は運用の継続率に直結します。
    3. **未回答ログ・分析機能**:答えられなかった質問・利用率・解決率をどこまで見られるか。==未回答ログが見えないツールでは、FAQを改善するサイクル自体が回せません==。
    4. **有人への引き継ぎ設計**:解決しなかったとき、問い合わせフォーム・チャット・メールへどうつなげるか。「ボットで終わり」の設計はたらい回し感を生みます。
    5. **社内ナレッジベースとの接続可否**:FAQデータをボット専用に閉じ込めるか、マニュアル・規程類と同じナレッジ基盤に置いてボットが参照する形にできるか。後者なら、整備した内容を問い合わせ対応以外のAI活用にも使い回せます。

    ▶ 関連記事: [社内チャットボットの作り方と運用のコツ](/blogs/internal-chatbot)

    ### 向いている企業・部署 — 情シス不在の30〜100名企業こそ候補

    部署単位で効果が出やすいのは、手続きの質問が集まる情シス・人事・総務・経理と、定番の質問が多いカスタマーサポートです。会社の規模で見ると、従業員30〜100名で専任の情シスがいない会社は有力な候補です。この規模では、ITに詳しいメンバーや総務が兼任で質問対応を引き受けており、割り込みのたびに本来の業務が止まっているからです。始め方は、全社一斉ではなく「社内のIT・総務の定型質問だけ」のような限定スタートが向いています。範囲が狭いほどFAQ整備の負担が小さく、未回答ログを見て直すサイクルも回しやすいためです。

    もう一つ持っておきたい視点は、チャットボットのために整えたFAQデータは、問い合わせ対応の専用資産ではないということです。1問1答に構造化され、現場の言葉で書かれ、更新の習慣があるFAQは、そのまま新人のオンボーディング資料になり、他の業務を担うAIの参照元になります。FAQ整備を「ボットの餌やり」ではなく社内ナレッジベースづくりの第一歩と位置づけると、同じ手間の回収先が広がります。

    ## 用語の要点

    – **FAQチャットボット**:よくある質問への回答をチャット形式で自動応答する仕組み。シナリオ型・FAQ検索型・生成AI・RAG型の3タイプがあり、実体は「ボット」と「FAQデータ」の組。AIヘルプデスク全体から見ると一次応答の部品にあたる。
    – **FAQシステムとの違い**:FAQページ・FAQシステムは利用者が検索して探す仕組み、チャットボットは対話で導く仕組み。優劣ではなく向く質問が違うため、併用と相互誘導が基本形。
    – **精度の分かれ目**:回答精度は登録FAQの量・鮮度・言い回しの網羅・専門用語対応で決まり、ツールの乗り換えでは解決しない。未回答ログを見てFAQを直す担当と時間を確保できるかが、導入前に確認すべき最重要の条件。

    ## よくある質問

    **Q. FAQチャットボットとは何ですか?どんな仕組みですか?**
    よくある質問(FAQ)への回答を、チャット形式の対話で自動応答する仕組みです。利用者が質問を入力するか選択肢を選ぶと、登録済みのQ&Aデータや社内文書から該当する答えを探して返します。答えの返し方によって、シナリオ型・FAQ検索型・生成AI・RAG型の3タイプに分かれ、後者ほど言い回しの違いに強くなります。

    **Q. チャットボットとFAQ(FAQシステム)は何が違いますか?使い分けは?**
    FAQページ・FAQシステムは利用者が一覧や検索窓から自分で答えを探す仕組みで、チャットボットは対話で答えまで導く仕組みです。答えが短く決まる定型質問はチャットボット、手順が長い内容や図表を見せたい内容はFAQページが向いています。実務では併用が基本で、ボットで解決しない質問をFAQページや有人窓口へ誘導する多段の設計が有効です。

    **Q. FAQチャットボットの費用・料金相場はいくらですか?**
    執筆時点(2026年7月)の複数メディアの報告値では、シナリオ型が月額数千円〜5万円程度、FAQ検索型(AI搭載)が月額10万〜50万円程度、生成AI・RAG型が月額15万〜50万円程度からが目安です。単一の相場額は存在せず、質問数・利用人数・チャネル数で変わるため、見積もりでは金額に加えて「初期のFAQ整備支援が含まれるか」を確認してください。

    **Q. FAQチャットボットを導入するとどんなメリットがありますか?**
    24時間365日の即答、定型質問の一次対応の工数削減、回答品質の均一化、そして質問ログの蓄積の4つです。特に、答えられなかった質問が未回答ログとして残ることで、FAQのどこに穴があるかをデータで把握できるようになる点は、工数削減と並ぶ独立した価値です。効果は定型的で答えを文書化できる質問に集中して出ます。

    **Q. FAQチャットボットの回答精度が上がらない・質問に対応できないのはなぜですか?**
    まず疑うのは、登録FAQの量・範囲の不足、言い回し・表記ゆれへの未対応、更新停止です。未回答ログを見てFAQを追記し、質問文を利用者の聞き方に合わせてください。正しい回答が存在するのに改善しない場合は、検索・照合、回答生成、権限・外部連携の順に切り分けます。原因がデータならFAQを直し、技術層なら設定・モデル・ツールを調整するのが適切です。

    **Q. FAQチャットボットの選び方・比較のポイントは何ですか?**
    ①言い換え対応の強さ ②現場の担当者だけでFAQを更新できるか ③未回答ログ・解決率の分析機能 ④有人への引き継ぎ設計 ⑤社内ナレッジベースとの接続可否——の5点です。デモで目立つ①だけでなく、運用を支える②③を同じ重みで確認してください。精度を維持するのは導入時の性能ではなく、導入後の更新サイクルです。

    **問い合わせ対応の自動化を「使われ続ける形」で進めたい方へ** — PolarisXは、①法人向けAIエージェントの開発 ②社内ナレッジベースの構築 ③AIコンサルティングサービスを提供する会社です。FAQを含む社内ナレッジベースを共有脳に、自社でも3部門・約20のAIエージェントを内製運用する当事者として、FAQデータの整備から更新が続く運用設計までをご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧ください。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社AI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。FAQを含む社内ナレッジベースをAIの共有脳として日々運用する立場から、本記事は教科書的な解説に「FAQデータの更新頻度と言い回しの網羅が精度を決める」という運用の判断基準を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [チャットボットの費用はいくら?初期費用・月額料金の相場から費用対効果の算出方法まで徹底解説(NTT東日本)](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)
    – [AIチャットボットの料金相場は?初期費用・月額費用・タイプ別比較を徹底解説【2026年版】(Tayori Blog・2026年)](https://tayori.com/blog/ai-chatbot-pricing/)
    – [AIチャットボットの料金・導入費用の相場は? 比較表・おすすめツール(ディーエスブランド dsマガジン)](https://ds-b.jp/dsmagazine/chatbot-cost/)
    – [【料金比較表】チャットボットの費用相場は月額24,000円 主要26サービス調査(BOXIL Magazine)](https://boxil.jp/mag/a8292/)
    – [チャットボットの正答率を向上させる方法とは?(RICOH Chatbot Service)](https://promo.digital.ricoh.com/chatbot/column/detail180/)

  • エージェントとは?意味・語源とAIエージェントとの違いを解説

    エージェントとは?意味・語源とAIエージェントとの違いを解説

    エージェントとは、本来「誰かの代わりに行動する代理人・仲介者」を意味する言葉です。IT・コンピュータの分野では、==環境から情報を受け取り、利用者に代わって行動するソフトウェア==を指します。その中でAIを判断に使うものがAIエージェントです。近年のニュースや営業資料では、特に生成AI(LLM)を使って計画やツール操作を行うタイプを指すことが増えています。

    なお、この記事はIT・ソフトウェアの文脈での「エージェント」という言葉の意味を整理する定義記事です。不動産エージェント・転職エージェントといった業界ごとの職業・サービスの実務解説や、特定のAIツールのエージェント機能の使い方は、この記事では扱いません。

    この言葉が分かりにくいのは、二重の多義性があるからです。第一に、日常語としてのエージェント(代理人・仲介者)とIT用語としてのエージェントが同じ顔で登場します。第二に、IT用語の中でも指す範囲が広く、検索エンジンのクローラーのような古典的なプログラムから、生成AIで動く最新のAIエージェントまでが同じ名前で呼ばれます。さらに近年は、自律的とは言いがたい自動化ツールまで「エージェント」を名乗る例が増えました。この記事では、語源から意味の全体像をたどり、種類・具体例・AIエージェントやRPAとの違いまでを一続きで整理し、読み終わった時点で「いま目の前の資料のエージェントはどの意味か」を自分で見分けられる状態を目指します。

    > **一言でいうと**:エージェントとは「誰かの代わりに行動する存在」を指す言葉です。人間なら代理人・仲介者を、ソフトウェアなら環境から情報を受け取り行動するプログラムを意味します。AIエージェントは、その判断にAIを使う一種です。
    >
    > **先に正しておきたい誤解3つ**
    > 1. **エージェント=AIエージェントのことである** : 本来はもっと広い言葉です。AIエージェントはソフトウェアエージェントの一種で、LLMは現在主流の実装方法の一つです。AIエージェントの定義上、LLMが必須というわけではありません。
    > 2. **IT用語のエージェントと、不動産・転職のエージェントは無関係である** : 語源は同じ「代理人」です。「本人の代わりに動く」という核の意味を、人間に当てはめるかソフトウェアに当てはめるかの違いです。
    > 3. **「エージェント」と名乗る製品は、みな同じ水準で自律的に動く** : そうとは限りません。条件に応じて固定ルールを実行する単純なエージェントから、目的に応じて計画を組み替えるものまで自律性には幅があります。製品名だけでなく、実際の振る舞いを確認する必要があります。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム): 司令塔AI社員「Polaris AI」を開発し、自社でも3部門・約20のAIエージェントからなるAI社員組織を内製運用するメンバーが執筆しています。

    ## エージェントとは|一言でいうと「誰かの代わりに行動する代理人」

    エージェントとは、英語の agent をそのまま取り入れた外来語で、「依頼した本人の代わりに判断し、行動する人・組織・仕組み」を指します。日常の用例では、選手に代わって契約交渉をするスポーツ選手の代理人、転職希望者に代わって求人を探し企業と調整する転職エージェント、売主・買主の代理として動く不動産エージェントのように、「本人の代わりに動く専門家」の意味で使われます。IT分野では、この「代わりに動く」という性質をソフトウェアに当てはめ、利用者に代わって自律的に働くプログラムをエージェントと呼びます。つまりエージェントは多義語に見えますが、核にある意味は一つで、==「誰かの代わりに行動する存在」==です。誰の代わりか(依頼者)と、何が動くか(人間かソフトウェアか)が変わるだけです。

    ![エージェントという言葉の意味の包含関係を示す図。最も外側に一般的な意味の「エージェント(代理人・仲介者)」、その中にIT分野の「ソフトウェアエージェント」、さらにその中にAIを使って判断する「AIエージェント」が含まれ、LLM型は現在主流の実装例であることを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig1-venn-word-scope.png)

    ### 語源はラテン語「agere(行動する)」

    英語の agent は、ラテン語の agere(行動する)に由来するとされ、原義は「行動する者」です。act(行動する)・action(行動)・agency(代理店・機関)と同じ語幹を持ちます。「本人に代わって行動する者」という発想から「代理人」の意味が生まれ、そこから各分野の用法が派生しました。国語辞典や語学解説サイトの整理では、日本語での「エージェント」の意味は大きく2系統にまとめられています。1つは代理人・仲介者・代理店(転職エージェント、芸能・スポーツの代理人、保険代理店など)、もう1つは諜報員・スパイ(映画などで登場する「エージェント」)です。どちらも「組織や本人の代わりに、現場で行動する者」という原義でつながっています。

    ### 一般的な意味:不動産・人材紹介・エンタメの「エージェント」との関係

    不動産・人材紹介・エンタメ業界の「エージェント」は、いずれも「依頼者の利益のために、専門知識を使って交渉・仲介・調整を代行する人・会社」という共通の構造を持ちます。転職エージェントは求職者の代わりに求人を探して条件を交渉し、不動産エージェントは売主や買主の代わりに相手方と調整し、芸能・スポーツのエージェントはタレントや選手の代わりに契約をまとめます。ソフトウェアとしてのエージェントも、実はこれと同じ構造です。「利用者の目的のために、利用者の代わりに動く」という役割を、人間ではなくプログラムが担っているだけです。この共通構造を押さえておくと、次章以降のIT用語としての意味がすっと入ってきます。なお、各業界の「エージェント」という職業・サービスの実務は本記事の対象外です。

    ## IT・コンピュータ分野におけるエージェントの意味と種類

    IT・コンピュータ分野におけるエージェント(ソフトウェアエージェント)とは、環境から入力を受け取り、利用者やシステムの代わりに行動するソフトウェアです。ポイントは3つあります。①データ・メッセージ・状態などを受け取る ②ルール・目標・評価基準などに基づいて次の行動を選ぶ ③処理・出力・外部システムの操作として環境へ働きかける、の3点です。どこまで自分で行動を選べるかという自律性には幅があり、常駐型だけでなく、イベントや依頼を受けて一定期間だけ動くものもあります。重要なのは、これは生成AIブームで生まれた言葉ではないということです。ソフトウェアエージェントという概念は1990年代以前からAI研究で扱われ、ITの現場でも「エージェント」と名の付く仕組みが長く使われてきました。

    ### 定義:環境を知覚し、規則に基づいて行動するソフトウェア

    学術的な裏づけも確認しておきます。AI分野の標準的な教科書『[Artificial Intelligence: A Modern Approach](https://aima.cs.berkeley.edu/4th-ed/pdfs/newchap02.pdf)』(Russell & Norvig)は、エージェントを「センサーによって環境を知覚し、アクチュエータによって環境に働きかけるもの」と定義しています。ソフトウェアエージェントの場合、知覚にあたるのはデータやメッセージの受信、行動にあたるのは処理・出力・他システムへの働きかけです。==環境から受け取った情報を、何らかの規則で行動へ結びつける==ことが共通点です。単純な条件反応だけを行うものもあれば、目標から計画を立てるものもあり、「目的だけを渡せば手順を組み立てる」ことは高度なエージェントの特徴であって、すべてのエージェントの定義要件ではありません。

    ### 分類の軸:判断方式とシステム構成

    エージェントには複数の分類軸があり、唯一の統一分類があるわけではありません。判断方式に注目すると、前述の教科書は基本設計を、単純反射エージェント・モデルベース反射エージェント・目標ベースエージェント・効用ベースエージェント・学習エージェントの5つに整理しています。単純反射型は現在の入力と条件・行動ルールから動き、目標ベース型は将来の状態を見越して行動を選び、学習型は経験から構成要素を改善します。別の軸では、ソフトウェア内で動くかロボットなどの物理機器を動かすか、単体で動くか複数で連携するか、といった分け方もできます。複数のエージェントが協力・競争する構成は「マルチエージェント」と呼ばれ、それ自体が大きなテーマなので別の記事で詳しく扱います。

    ![ITにおけるエージェントの分類軸を示すツリー図。判断方式の枝には単純反射・モデルベース・目標ベース・効用ベース・学習型が、構成の枝には単体・マルチエージェント・物理機器と連携するエージェントが並ぶ](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig2-tree-classification.png)

    ### 具体例:クローラー・メール振り分け・監視エージェント

    身近な具体例を挙げると、「エージェント」が昔からIT の足元にいたことが分かります。代表例は検索エンジンのクローラーです。クローラーは、検索エンジンの利用者や運営者の代わりにWeb上のページを自律的に巡回し、情報を収集し続けるプログラムで、ソフトウェアエージェントの古典的な実例とされています。ほかにも、条件に応じてメールを自動で仕分けるメールフィルタ、監視ツールが各サーバーに常駐させて状態を報告させる「監視エージェント」、ウイルス対策ソフトが各PCに配布する「エージェント」プログラムなどがあります。Webの通信でブラウザを識別する「User-Agent(ユーザーエージェント)」という項目名も、「ブラウザ=利用者の代理としてWebサーバーと対話するソフトウェア」という発想の名残です。いずれも「人の代わりに、決められた目的のために働き続けるプログラム」という共通点を持ちます。

    ## エージェント・RPA・チャットボット・AIエージェントは何が違うのか

    4つの言葉は、厳密には同じ階層の分類ではありません。エージェントはシステムの捉え方、RPAは定型操作を自動化する用途、チャットボットは対話という窓口、AIエージェントはAIを使って目標を追う仕組みを指すため、重なる場合があります。たとえばシナリオ型チャットボットを単純なソフトウェアエージェントと捉えることも、RPA製品が端末上の「エージェント」部品を持つこともあります。実務で製品を比べるときは、典型的な実装について「手順を人が固定するのか、目的に応じてシステムが計画を変えるのか」を見ると整理しやすく、==自律的な判断の有無と幅==が任せられる仕事を分けます。

    ![典型的なRPA・シナリオ型チャットボット・近年のLLM型AIエージェントを、縦軸に自律性の高さ、横軸に扱える業務の幅をとった2軸マップで比較した図。製品によって位置は変わり、3つの概念が完全に排他的ではないことを注記する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig3-matrix-comparison.png)

    ### AIエージェントとの関係:AIを使う広い概念と、近年のLLM型を分ける

    AIエージェントは、AIを使って利用者の代わりに目標を追い、環境を認識して行動するソフトウェアシステムです。[Google Cloudの公式解説](https://cloud.google.com/discover/what-are-ai-agents?hl=ja)も「AIを使用してユーザーの代わりに目標を追求し、タスクを完了させるソフトウェアシステム」と説明しています。学術的・歴史的には、条件・行動ルール、探索・計画、機械学習などで実装される知的エージェントを含むため、==AIエージェントの定義にLLMは必須ではありません==。一方、現在のビジネス文脈で注目されるAIエージェントの多くはLLMを基盤にしており、自然言語で目標を受け取り、外部ツールを選び、途中の結果に応じて計画を変えられます。LLMはAIエージェントそのものの定義ではなく、扱える仕事の幅を大きく広げた現在主流の実装方法、と捉えると混同を避けられます。

    ### RPA・チャットボットとの違い:自律性の幅で比べる

    RPA・チャットボットとの違いは、典型的な実装に比較の観点を揃えると見分けやすくなります。製品によって機能は重なるため、名称だけで判定せず、次の表を出発点に実際の仕様を確認してください。

    | 観点 | 典型的なRPA | シナリオ型チャットボット | 近年のLLM型AIエージェント |
    |—|—|—|—|
    | 指示の与え方 | 操作手順を人が定義する | 想定問答・シナリオを人が用意する | 目的・ゴールを言葉で伝える |
    | 判断の柔軟さ | 人が定義した手順・条件の範囲 | 用意した範囲で応答する | 状況に応じて手順を組み立て直す |
    | 得意な仕事 | 定型・反復の事務処理 | 問い合わせへの一次応答 | 複数ステップの調査・作成・調整 |
    | 想定外への反応 | 停止・エラーになることが多い | 未回答・有人窓口へ誘導する | 設計に応じて代替手段・人への確認・停止を選ぶ |

    3つは優劣の関係ではなく、適材適所の関係です。手順が固定された大量の反復処理なら、判断範囲を狭くしたRPAのほうが安く確実に動きます。よくある質問への応答が目的なら、チャットボットで十分です。近年のLLM型AIエージェントが活きるのは、状況に応じた判断や複数ステップの段取りが必要な仕事です。この「どの水準が要る仕事か」という仕分けは、後半の実務の見極めで再登場します。

    ### マルチエージェント・ChatGPTのエージェント機能はどこに位置づくか

    最近よく見かける関連語も、この地図の上に置けます。ChatGPTのエージェント機能(エージェントモード)は、LLM型AIエージェントを特定のツール上で実現した例の一つで、単体のAIが調べ物や作業を進めます。マルチエージェント(マルチAIエージェント)は、役割の異なる複数のAIエージェントが連携して一つの業務を分担する構成です。エージェンティックAIは、AIが目標に向けて計画・行動する性質や、それを実現するシステム全体を指す表現として使われています。いずれもソフトウェアエージェントの系譜に連なりますが、「AIエージェント」という語だけではモデル・自律性・構成までは決まらないため、個別の仕様を確認する必要があります。

    ## なぜいま「AIエージェント」という意味が急速に広まっているのか

    エージェントという言葉自体は30年以上前からあるのに、いま急速に耳にするようになった理由は、技術と制度の2つの変化で説明できます。技術面では、生成AI(LLM)の進化により、自然言語で幅広い目的を受け取り、外部ツールを使いながら複数ステップを進められる範囲が広がりました。制度面では、国のガイドラインでも「AIエージェント」が扱われ、企業がリスクとともに検討すべき用語として定着しつつあります。古い概念にLLMという新しい実装方法が加わり、適用できる業務が増えたことが、使用場面の拡大につながっています。

    ![エージェントという言葉が指す対象の変遷を示すタイムライン図。1990年代のソフトウェアエージェント研究とクローラーなどの古典的エージェントから、ルールベースの自動化・RPA・チャットボットの普及を経て、生成AIの登場により自律的に計画・実行するAIエージェントへ意味の中心が移ってきた流れを時間軸で表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig4-timeline-evolution.png)

    ### 生成AI(LLM)の進化で「自律的な判断」が実用になった

    従来から、目標探索・計画・機械学習を使う高度なエージェントは研究されてきました。ただし業務システムとして広く普及したものは、事前に書いたルールや限られた入力を扱う実装が中心でした。生成AIは、自然言語で与えられた目的を解釈し、手順を計画し、途中の結果を評価して軌道修正する機能を、幅広い業務へ組み込みやすくしました。もう一つの変化は、作る側の裾野が広がったことです。現在はノーコードツールやAPIを組み合わせて、中小企業が自社の業務に合わせたLLM型AIエージェントを用意することも現実的になっています(作り方の具体的な手順は、別途手順記事として扱う予定です)。

    ### 制度面の動き:AI事業者ガイドラインが「AIエージェント」を定義した

    言葉の広がりを後押ししたもう一つの要因が、公的な文書での整理です。総務省・経済産業省が2026年3月に公表した[AI事業者ガイドライン(第1.2版)](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html)は、自律的にタスクを実行するAIシステムを「AIエージェント」として定義に加え、関連する構成にも言及しました。ただし、これは製品を認定する法律上の基準ではなく、すべての研究・製品で一つの定義が強制されるわけでもありません。企業が導入・利用時のリスクとともに検討すべき用語として公的文書にも登場した、と捉えるのが適切です。だからこそ、次章で扱う「言葉の中身の見極め」が実務では重要になります。

    ## 実務で見る誤解|「エージェント」の意味を取り違えると起きる問題

    エージェントという言葉の意味の曖昧さは、実務では2方向の問題を生みます。1つ目は過大評価です。「エージェント搭載」とうたう製品を導入したら、実態は固定シナリオの自動化で、期待した「目的を渡せば任せられる」働き方にはならなかった、というギャップです。2つ目は過小管理です。本当に自律性の高いエージェントを、従来の自動化ツールと同じ感覚でノーチェックのまま動かしてしまい、誤った判断に気づく仕組みがない、という状態です。どちらも、言葉のイメージと実物の自律性の水準がずれていることが原因です。防ぐには、名前ではなく自律性の中身を確認する軸を持つことです。

    ### 「エージェント」と称していても、実態がルールベースの自動化である製品がある

    前提として押さえておきたいのは、「エージェント」という言葉には製品を一律に認定する法律や業界標準がない、ということです。AIエージェントへの注目が高まった結果、従来はRPA・ワークフロー自動化・シナリオ型チャットボットと呼ばれていた仕組みが、「エージェント」として紹介される例もあります。これは必ずしも誤用ではありません。ここまで見てきたとおり、エージェントはシステムを分析するための広い概念であり、ルールで反応する単純反射型もエージェントとして扱われます。ただし買い手にとっては、月額費用も任せられる仕事の質も大きく違うものが同じ名前で並ぶことになります。だからこそ、売り手の呼び方ではなく、買い手側の確認軸で自律性とAIの使い方を見分ける必要があります。

    ### 現場でよく見る誤解と、私たちの見極め

    私たちPolarisXは、司令塔AI社員「Polaris AI」というエージェントの実装そのものを開発・提供し、自社でも3部門・約20のAIエージェントに業務を任せて運用しています。作る側・使う側の両方の立場でこの言葉の混乱を日常的に見てきた経験から、営業資料やニュースで「エージェント」という言葉に出会ったときに確認しているのは、次の3点です。

    1. **目的を伝えるだけで、手順を自分で組み立てるか**:実行する手順・分岐をすべて人が設定する仕組みなら、それはワークフロー自動化・RPAの系譜です。「目的を渡すと段取りを自分で考える」水準かを、デモで具体的に確認します。
    2. **想定外の状況に遭遇したとき、どう振る舞うか**:想定外の入力で停止するのか、人に確認を求めるのか、代替手段を試すのか。この振る舞いの設計こそ自律性の実力が表れる部分です。
    3. **エラー・誤判断が起きたとき、ログで追跡できるか**:自律的に動くということは、人が見ていない場面で判断するということです。何を根拠にどう判断したかを後から追える仕組みがなければ、業務には安心して組み込めません。

    判定の基準も先に決めておきます。==決められた手順だけを実行するなら、呼び名にかかわらず固定手順型の自動化として評価する==のが実務的です。広い意味ではソフトウェアエージェントと呼べても、目的から計画を組み立てるLLM型AIエージェントと同じ自律性はありません。その場合はRPAやワークフロー自動化と同じ軸で費用対効果を確認し、「AIだから」という理由だけで上乗せ価格を受け入れないことが重要です。自律性が確認できたら、次に見るべきはログに加えて、権限の範囲や人の承認を挟む場所といった制御の設計です(AIエージェントのセキュリティ・リスクの深掘りは、別の記事で扱う予定です)。

    ![エージェントと呼ばれる仕組みの自律性を3段階で示した図。1段目は広義にはエージェントとも呼ばれる固定手順型、2段目は条件分岐やシナリオの範囲で動く条件反応型、3段目は目的から手順を組み立てる目標駆動型で、呼び名ではなく必要な水準との一致を確認する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig5-ladder-autonomy-levels.png)

    ## 実務での見極め|「エージェント」という言葉を聞いたら何を確認するか

    提案や記事で「エージェント」という言葉に出会ったときの確認は、3ステップで行えます。①言葉の文脈を確認する:人間の代理人の話か、ソフトウェアの話か。ソフトウェアなら、どの入力を受け、どの規則やAIで行動を選ぶのか。②自社の業務を仕分ける:任せたい仕事は、手順が固定された定型反復か、想定問答への応答か、それとも状況判断と複数ステップの段取りが必要な仕事か。③水準の一致を確認する:提案されている仕組みの自律性の水準(前章の3点)が、その仕事に必要な水準と合っているか。この3ステップを踏むだけで、言葉の印象に引きずられた過大な期待も、必要以上に高機能なものを買う過剰投資も避けられます。

    ### 自社の業務に当てはめて考える:RPA・チャットボット・AIエージェントの仕分け

    業務側から考えると、答えはシンプルになります。毎月同じ手順で行う請求処理やデータ転記のような定型反復なら、RPAや通常の自動化が最有力です。判断が要らない仕事に高い自律性は不要で、固定手順のほうが速く、安く、確実だからです。社内外からのよくある質問への応答が目的なら、チャットボット(またはFAQの仕組み)が候補です。一方、調査して資料をまとめる、複数の情報源を突き合わせる、状況に応じて段取りを変えるといった仕事は、LLM型AIエージェントの能力が活きる領域です。「AIエージェントを導入したい」から入るのではなく、「この仕事にはどの水準の自律性が要るか」から入ると、名前に惑わされない選定ができます。

    ![エージェントという言葉に出会ったときに確認する3つの質問をチェックリストカードで示した図。文脈はどの意味のエージェントか、任せたい業務は定型反復か応答か自律判断か、提案された仕組みの自律性は業務に必要な水準と合っているか、の3項目を確認欄つきで並べる](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-agent-basics-fig6-checklist-word-check.png)

    ### AIエージェントを組織に配属して運用する形:「AI社員」という考え方

    最後に、この言葉の地図の先にある運用の話を一つだけ紹介します。AIエージェントを単発のタスク実行ツールとして使うのではなく、社内の情報(ナレッジ)と接続し、部門の業務を継続的に分担する形で運用する考え方があります。私たちはこれを「AI社員」と呼んでいます。人間の社員と同じように、担当業務を持ち、社内の文脈を踏まえて働き、日々の運用の中で改善されていく形です。エージェントという言葉の原義が「本人の代わりに行動する者」だったことを思い出すと、AI社員はその原義を組織の中で最も素直に実現した形ともいえます。自社で運用してみて実感するのは、エージェントの働きの質は、頭脳であるAIモデルの性能だけでなく、参照できる社内情報の整備と、任せる業務の切り出し方で大きく変わるということです。この運用形態の詳しい解説は、別の記事に譲ります。

    **「この提案のエージェントは、どの水準の自律性なのか」を一緒に見極めたい方へ**:PolarisXは、社内ナレッジベースと接続して働く司令塔AI社員「Polaris AI」を提供しています。自社でも約20のAIエージェントを内製運用する当事者として、言葉の整理から業務の仕分け・導入の設計までをお手伝いします。無料相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ## 用語の要点

    – **エージェント**:「誰かの代わりに行動する存在」を指す言葉。ラテン語 agere(行動する)に由来し、人間なら代理人・仲介者を、IT分野では環境から情報を受け取り、何らかの規則で行動するソフトウェアを指す。
    – **AIエージェントとの関係**:AIを使って目標を追い行動するソフトウェアエージェント。LLMは定義上の必須要件ではなく、自然言語・計画・ツール操作の範囲を広げた現在主流の実装方法。RPA・チャットボットとは概念が重なるため、名称ではなく自律性と用途で比べる。
    – **実務の見極め**:「エージェント」と名乗る仕組みの自律性には幅がある。①目的から手順を自分で組み立てるか ②想定外にどう振る舞うか ③判断をログで追跡できるか、の3点で確認し、固定手順の実行だけならRPAとして費用対効果を評価する。

    ## よくある質問

    **Q. エージェントとは何ですか?意味をわかりやすく教えてください。**
    エージェントとは、「依頼した本人の代わりに判断し、行動する人・組織・仕組み」を指す言葉です。英語 agent の語源はラテン語の agere(行動する)で、原義は「行動する者」です。日常語では転職エージェントや芸能・スポーツの代理人のように人間の専門家を指し、IT分野では利用者に代わって自律的に働くソフトウェアを指します。

    **Q. IT・ソフトウェアの分野で「エージェント」とは何を指しますか?**
    環境からデータや状態を受け取り、利用者や他のシステムの代わりに行動するソフトウェアを指します。検索エンジンのクローラー、メールの自動振り分け、サーバーに常駐する監視エージェントなどが古くからの実例です。自律性には、固定ルールで反応するものから、目標に応じて計画を変えるものまで幅があります。

    **Q. エージェントとAIエージェントは何が違いますか?**
    ソフトウェアエージェントは環境から情報を受けて行動する仕組みを広く指し、AIエージェントはその判断にAIを使う一形態です。AIエージェントにLLMは必須ではありませんが、近年注目されるタイプはLLMを基盤に、言葉で目標を受け取って計画・ツール操作・評価を行います。「AIを使うか」と「どの程度自律的か」を分けて確認するのがポイントです。

    **Q. AIエージェントとRPA・チャットボットは何が違いますか?**
    実務上の比較軸は、自律的な判断の有無と幅です。典型的なRPAは人が定義した操作手順を反復し、シナリオ型チャットボットは用意された範囲で応答します。近年のLLM型AIエージェントは、目的に応じて手順を組み立て、途中結果を踏まえて複数ステップの仕事を進めます。ただし概念は重なるため、3者を排他的な製品分類と捉えず、実際の仕様で比較してください。

    **Q. 不動産エージェントや転職エージェントも、ソフトウェアエージェントと同じ意味ですか?**
    指すものは異なりますが、語源は同じです。どちらも「本人の代わりに行動する代理人」というラテン語由来の原義を共有しており、それを人間の専門家に当てはめたのが不動産・転職エージェント、ソフトウェアに当てはめたのがソフトウェアエージェントです。文脈が業界の職業・サービスの話か、ITの仕組みの話かで見分けられます。

    **AIエージェントの導入を「言葉の整理」から始めたい方へ**:PolarisXは、①法人向けAIエージェントの開発 ②社内ナレッジベースの構築 ③AIコンサルティングサービスを提供する会社です。自社でも3部門・約20のAIエージェントを内製運用する当事者として、自社に必要な自律性の水準の見極めから導入・定着までをご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧ください。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社AI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。エージェントを作る側・使う側の両方の現場から、本記事は用語の教科書的な解説に「名前ではなく自律性の中身を確認する」という実務の判断基準を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [AI事業者ガイドライン(第1.2版)(総務省・経済産業省、2026年)](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html)
    – [Artificial Intelligence: A Modern Approach, Chapter 2: Intelligent Agents(Russell & Norvig・公式PDF)](https://aima.cs.berkeley.edu/4th-ed/pdfs/newchap02.pdf)
    – [AI エージェントとは(Google Cloud 公式解説)](https://cloud.google.com/discover/what-are-ai-agents?hl=ja)
    – 語源(ラテン語 agere 由来)と国内IT用語解説におけるエージェントの分類は、複数の語学・IT用語解説サイトで一致する記述(報告値)に基づいています。個別の製品・サービスの仕様は各社公式サイトをご確認ください。

  • マルチモーダルRAGとは?仕組み・活用場面・限界をわかりやすく解説

    マルチモーダルRAGとは?仕組み・活用場面・限界をわかりやすく解説

    マルチモーダルRAG(Multimodal RAG)とは、テキストだけでなく画像・図表・音声・動画といった複数のデータ形式(モダリティ)を検索対象に含め、見つけた内容に基づいてAIが回答を生成する、RAG(Retrieval-Augmented Generation・検索拡張生成)の拡張手法です。

    この言葉に出会うのは、多くの場合、社内ナレッジベースやRAGの検討を進めている途中です。「普通のRAGと何が違うのか」「うちは図面やスキャン書類が多いが、それもAIに読ませられるのか」——そこで調べ始めると、似た言葉(マルチモーダルAI・マルチモーダルLLM)や製品カタログの「マルチモーダル対応」表記が入り混じり、かえって分かりにくくなります。この記事は、通常のRAGとの違い→仕組み→効く場面→効かない場面・限界→自社に必要かの見極め、の順で、非エンジニアの経営者・DX推進責任者が導入判断できるレベルまで噛み砕いて整理します。

    **一言でいうと** — マルチモーダルRAGは「画像・図表・音声まで”読んで”答えるRAG」です。

    **よくある3つの誤解**

    – **「マルチモーダルAIと同じもの」** — 別物です。マルチモーダルAI(マルチモーダルLLM)は複数のデータ形式を理解できる「モデル」そのもの。マルチモーダルRAGは、そのモデルを部品として使い、社内の資料を「検索して根拠つきで答える仕組み」です。
    – **「画像認識(OCR)を足しただけのもの」** — 文字の読み取り(OCR)は手段の一つにすぎません。図や写真をどうやって「検索できる形」に索引化するかという、検索の設計レベルで通常のRAGと異なります。
    – **「高性能なRAG製品を買えば自動で使える機能」** — 製品側が対応していても、元データの解像度やキャプションなど「データ側の質」が整っていなければ精度は出ません。導入とデータ整備はセットです。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— AI社員「Polaris AI」の開発と、自社のAI社員組織(複数部門で約20のAIエージェント)の運用に携わるメンバーが執筆しています。

    ## マルチモーダルRAGとは|画像・図表・音声も「読んで」答えるRAG

    マルチモーダルRAGとは、テキストに加えて画像・図表・音声・動画などの非テキストデータを検索対象に含め、質問に関係する箇所を見つけ出し、その内容を根拠に生成AIが回答するRAGの拡張手法です。通常のRAG(シングルモーダルRAG)が検索できるのはテキストだけなので、図面・現場写真・スキャンされた契約書・グラフ入りの資料は「そこに存在するのに、AIからは見えない」情報になります。マルチモーダルRAGは、この読み飛ばされてきた情報をAIの回答の根拠に加えるための技術です。

    前提となるRAGを一言でおさらいすると、RAGは「AIが回答を作る前に、社内文書などの情報源を検索して読み、その内容に基づいて答える仕組み」です(原典は [Lewis et al., 2020](https://arxiv.org/abs/2005.11401))。汎用の生成AIが自社の質問に答えられないのは能力不足ではなく自社の文脈を知らないからで、RAGはその文脈を検索で補います。ただし、ここで検索できるのは基本的にテキストでした。

    一方で、会社の重要な情報はテキストだけで完結していません。製造業の図面、店舗の写真入りマニュアル、押印済みのスキャン契約書、ホワイトボードを撮った写真、グラフだらけの月次資料——。通常のRAGを導入した会社が「マニュアル本文は答えるのに、そこに貼られた図の中身は答えられない」「スキャンPDFを読ませたら『読めません』と返ってきた」という壁に当たるのは、この構造が原因です。マルチモーダルRAGは、まさにこの壁を埋めるために登場しました。

    ### 通常のRAG(シングルモーダル)との違い

    両者の違いは、次の4点で整理できます。

    | 比較軸 | 通常のRAG(シングルモーダル) | マルチモーダルRAG |
    |—|—|—|
    | 検索対象のデータ | テキスト(文書・チャットログ等) | テキスト+画像・図表・音声・動画 |
    | 索引(インデックス)の作り方 | テキストをベクトル化して登録 | 画像等もベクトル化する、またはテキストに変換して登録 |
    | 使うモデル | テキスト用の埋め込みモデル+LLM | マルチモーダル対応の埋め込みモデル+マルチモーダルLLM |
    | 答えられる質問 | 文章に書いてあること | 図表・画像・音声に含まれる内容まで |

    重要なのは、これが「読めるファイル形式が増える」という話ではない点です。PDFという同じファイル形式でも、テキストが埋め込まれたPDFは通常のRAGで読めますが、スキャン画像だけのPDFは読めません。違いを生むのは形式ではなく、「中身が検索できる形に索引化されているか」です。

    ### 「マルチモーダルAI」「マルチモーダルLLM」との違い

    マルチモーダルAI(マルチモーダルLLM)は、テキスト・画像・音声など複数のデータ形式を入力として理解・生成できるAIモデルそのものを指します。汎用AIチャットに画像を貼り付けて「この図を説明して」と頼めるのは、この能力です。一方、マルチモーダルRAGは、そのモデルを部品として組み込み、大量の社内資料の中から質問に関係する箇所を検索して答える「仕組み全体」を指します。

    つまり関係は「モデル(部品)と仕組み(全体)」です。画像を1枚渡して読ませることと、何千ファイルの中から「この設備の点検手順が写っている図はどれか」を探し出して答えることの間には、検索・索引化という別の技術課題があります。マルチモーダルLLMが使えること自体は、マルチモーダルRAGが構築済みであることを意味しません。この区別が、後述の「既存ツールで使えるか」を考えるときの土台になります。

    ![マルチモーダルAI・LLMとRAGの関係を示すベン図。複数のデータ形式を理解できるモデルであるマルチモーダルAIと、社内文書を検索して根拠つきで答える仕組みであるRAGの重なりがマルチモーダルRAGであることを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multimodal-rag-fig1-venn-rag-boundary.png)

    ## マルチモーダルRAGの仕組み|画像や図表を「検索できる形」にする3つの方式

    マルチモーダルRAGの技術的な核心は、「画像や音声を、テキストと同じように検索できる形へ変換して索引化すること」にあります。その実現方法は、大きく3つの方式に整理して語られています。①テキストと画像を同じベクトル空間に埋め込む方式、②モダリティごとに別々の検索ストアを持つ方式、③画像をテキストに変換して1つのモダリティに統合する方式です。どの方式でも、その後の「質問→検索→回答生成」という流れは共通で、違いは「検索の入り口をどう作るか」に集約されます。コードの実装手順は本記事では扱いませんが、方式の違いを知っておくと、製品・ベンダーの説明を評価できるようになります。

    – **方式① 同じベクトル空間に埋め込む** — テキストと画像を、意味が近いもの同士が近くに配置される共通の「ベクトル空間」へ変換(埋め込み・Embedding)し、1つのベクトルデータベースで横断検索します。画像とテキストを対応づける対照学習のCLIP([Radford et al., 2021](https://arxiv.org/abs/2103.00020))がこの系譜の代表で、文書ページを画像のまま索引化するColPali([Faysse et al., 2024](https://arxiv.org/abs/2407.01449))のような文書検索特化の手法も登場しています。Google Cloudの公式ドキュメントも、マルチモーダル埋め込みでは画像とテキストのベクトルが同じ意味空間に置かれ、テキストで画像を検索できると説明しています([Vertex AI Embeddings APIs](https://cloud.google.com/vertex-ai/generative-ai/docs/embeddings/get-multimodal-embeddings))。
    – **方式② モダリティごとに別のストアを持つ** — テキストはテキスト用、画像は画像用のデータベースで別々に検索し、結果を突き合わせて回答に使います。モダリティごとに最適なモデルを選べる反面、検索結果の統合ロジックが必要になります。
    – **方式③ 画像をテキストに変換して統合する** — 図や写真にマルチモーダルLLMで説明文(キャプション)を生成させ、あるいはOCRで文字を抽出し、テキストとして通常のRAGに載せる方式です。既存のテキストRAG資産をそのまま活かせるため、実務ではここから始めるケースが多く報告されています。変換時に情報が落ちる(図の位置関係やニュアンスが説明文に残らない)ことが弱点です。

    ### 検索から回答生成までの流れ

    利用時の流れは、方式によらず次の4段階で捉えられます。

    1. **取り込み(事前準備)** — 社内の文書・画像・図表を、選んだ方式で「検索できる形」(ベクトルまたはテキスト)に変換し、データベースに索引化しておく。
    2. **質問の変換** — ユーザーの質問(例:「この型番の部品の取り付け向きは?」)を、同じ空間で比較できる形に変換する。
    3. **検索と統合** — テキスト・画像を横断して関連する箇所を探し、回答の材料として集める。
    4. **回答生成** — マルチモーダルLLMが、集めたテキストと画像を読み、根拠を添えて回答を組み立てる。

    このうち導入の成否を最も左右するのは、実は最初の「取り込み」です。ここで元データの質が低いと、後段がどれだけ高性能でも精度が出ません(詳しくは「効かない場面・限界」で述べます)。

    ![マルチモーダルRAGの検索から回答生成までの流れを示す4ステップのフロー図。文書と画像の取り込みと索引化、質問の変換、モダリティ横断の検索と統合、マルチモーダルLLMによる根拠つきの回答生成の順に進むことを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multimodal-rag-fig2-steps-retrieval-flow.png)

    ## マルチモーダルRAGが効く場面|図面・写真・スキャン文書が多い会社

    マルチモーダルRAGの効果が出やすいのは、業務の根拠となる情報が非テキスト資料に偏っている会社・部門です。逆に、社内の重要情報がほぼテキストで完結しているなら、通常のRAGとナレッジ整備で十分なことが多く、マルチモーダル化は過剰投資になりえます。報告されている活用領域は、製造・建設業の図面・CADデータの検索、現場写真やスキャン書類の活用、グラフ・フローチャート入り資料の読解などに集中しています。共通するのは「人がこれまで、目で図を見て判断していた業務」であることです。

    – **製造・建設** — 過去の図面・CAD・設備写真の中から類似設計や保全手順を探す、技術資料から設計データを抽出するといった活用が報告されています。ベテランが「あの図面のあの部分」と記憶で引いていた検索を、AIに肩代わりさせる方向です。
    – **店舗・サービス業** — 写真入りの業務マニュアル、売場レイアウト図、調理・接客手順の図解など、「文章より写真で伝えてきた」ナレッジを検索対象にできます。
    – **バックオフィス** — スキャンでしか残っていない契約書・押印済み書類・手書き帳票。紙文化の名残が強い会社ほど、テキスト検索から漏れている資産が大きい領域です。
    – **企画・資料読解** — グラフの軸や凡例を読んで数値の傾向を把握する、フローチャートの分岐から手順を読み取るなど、「図の中身」への質問に答えられるようになります。

    ### PolarisXが見る「効くサイン」

    私たちPolarisXは、約20のAIエージェントが共有の社内ナレッジを毎日読み書きするAI社員組織を自社で運用しています。その経験から言えるのは、AIの回答精度を決めるのは第一に「ナレッジがAIの読める形になっているか」だということです。私たちは全ナレッジを見出しと箇条書きで構造化したテキストに統一することで精度を安定させましたが、この方法には限界もあります。図面・写真・手書きメモにしか残っていないノウハウは、テキスト化の網からこぼれるのです。

    そこで実務での見極めとして、私たちは次のサインを見ます。**エース社員が「この図を見れば分かる」で仕事を回している。品質検査や施工の判断基準が写真ベースで共有されている。過去の見積・契約がスキャンでしか残っていない。**——こうした会社では、テキストのマニュアル整備だけでは属人化が解消されず、非テキスト資料まで検索対象に含める価値が大きくなります。逆に、これらに当てはまらないなら、マルチモーダルRAGの検討より先に、テキストナレッジの整備を進めるほうが投資対効果は高いはずです。

    ![マルチモーダルRAGが効く場面の一覧表。製造・建設、店舗・サービス業、バックオフィス、企画・資料読解の4つの場面ごとに、眠っている非テキスト資料と、AIに聞けるようになることを対で示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multimodal-rag-fig3-table-usecases.png)

    ## マルチモーダルRAGが効かない場面・限界

    マルチモーダルRAGは万能ではありません。限界は大きく3つあります。第一に、元データの質が低いと精度が出ないこと。第二に、通常のRAGより開発難易度・計算資源・運用コストが上がると報告されていること。第三に、テキストで足りる会社にとっては過剰投資になることです。導入を検討する段階では、「何ができるか」と同じ重みで「どういう条件だと効かないか」を押さえておく必要があります。この節では、私たちが現場で繰り返し見る「精度が出ない典型パターン」と、費用の考え方を整理します。

    技術面の負担から見ておくと、マルチモーダルRAGは非テキストデータの解析・索引化という工程が加わるぶん、構築の難易度と計算資源の消費が通常のRAGより大きくなると各種解説で報告されています。埋め込みモデルやマルチモーダルLLMの選定肢もテキストのみの場合より複雑で、検証(本当に図表を正しく読めているかのテスト)にも手間がかかります。「対応をうたう製品を入れれば終わり」ではなく、検証と運用の工数まで含めて見積もるのが実務的です。

    ### 精度が出ない典型パターン

    私たちが自社運用や相談の場で見るかぎり、マルチモーダルRAGの精度問題の多くは、モデルの性能ではなくデータ側の質で起きます。典型は次の4つです。

    – **解像度の低いスキャン** — 文字や図の線がつぶれた状態では、どんなモデルでも読み取れません。読めないものは索引化もされません。
    – **キャプション・凡例のない図** — 「何の図か」の手がかりがない画像は、人にとってもAIにとっても文脈不明です。検索でヒットしても、回答の根拠として使えません。
    – **ノイズの多い手書きメモ** — 走り書き・略語・矢印だらけのメモは誤読の温床です。重要なものは清書またはキャプション付与が先です。
    – **図と本文の対応が切れている** — 「どの手順に対応する図か」が紐づいていないと、検索は当たっても答えがずれます。ファイル名・配置・参照関係の整理が効きます。

    反証可能性の観点で言えば、**導入後もAIが図面や図表の内容を的外れに答え続けるなら、それはツールの性能限界と断定する前に、データの前処理(解像度の確保・キャプション付与・図と本文の紐づけ)が先だという合図**です。前処理を直しても改善しない場合に初めて、方式やモデルの見直しを検討する——この順序が、原因の切り分けを速くします。

    ### 導入費用の考え方(執筆時点の報告値)

    費用は構成による幅が非常に大きく、単一の相場では語れません。解説記事で報告されている執筆時点の目安では、RAG機能を持つSaaS型なら月額数万円程度から、小規模な個別構築で100万〜500万円程度、大規模な構築・運用では年間数百万〜数千万円規模とされています([intra-mart, 生成AIの導入にかかる費用相場](https://www.intra-mart.jp/im-press/useful/cost-ai))。マルチモーダル対応は非テキストデータの解析工程が増えるぶん、テキストのみの構成より費用が上振れする傾向があると報告されていますが、具体的な倍率を示す一次情報は確認できなかったため、本記事では倍率を明示しません。いずれも二次情報による報告値であり、要件しだいで大きく変わるため、本記事では断定しません。

    実務でむしろ費用を決めるのは、金額の相場より「対象範囲の絞り込み」です。全文書・全モダリティを一度に対象にすれば構築も検証も高くつきます。「どの文書を・誰が・何のために引くのか」を1部門・1用途に絞って始めれば、SaaS型や方式③(テキスト化)のような軽い構成で検証でき、効果を確かめてから広げられます。

    ![マルチモーダルRAG導入費用の目安をスケール帯で示した図。SaaS型は月額数万円から、小規模構築は100万から500万円程度、大規模構築は年間数百万から数千万円規模という執筆時点の報告値を帯で示し、幅が大きく断定できないことを注記する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multimodal-rag-fig4-gauge-cost-range.png)

    ## 実務での見極め|自社にマルチモーダルRAGは必要か

    自社にマルチモーダルRAGが必要かは、2つの判断軸で見極められます。**軸①: 社内の重要な情報は、テキストだけで完結しているか。それとも図面・写真・スキャン書類に依存しているか。軸②: 通常のRAGをすでに使っていて、「図表の中身までは答えられない」という壁に実際に当たっているか。**——軸①がテキスト中心なら、通常のRAGとナレッジ整備で十分です。軸①が非テキスト依存でも、壁にまだ当たっていないなら、まずキャプション付与やテキスト化(方式③)で拾えるかを試すのが低コストです。両方に当てはまって初めて、マルチモーダルRAGの本格検討フェーズに入ります。

    この順序を踏むと、判定は次の3段階に整理できます。

    1. **通常のRAGで十分** — 重要情報がテキストで完結している。やるべきはマルチモーダル化ではなく、ナレッジのテキスト構造化と検索性の整備。
    2. **まずデータの前処理から** — 図・スキャンは多いが、解像度やキャプションの整備が未着手。前処理とテキスト化で拾える範囲を確かめてから判断する。
    3. **マルチモーダルRAGを検討** — 非テキスト資料への依存が高く、前処理やテキスト化では拾い切れない「図そのものへの質問」が業務に多い。

    ### Dify・ChatGPTなど既存ツールでの対応状況(執筆時点)

    「自社で試せるのか」という疑問には、概念だけ整理しておきます。オープンソースのAIアプリ開発基盤Difyは、v1.11.0以降でナレッジベースのマルチモーダル対応が追加され、Vision対応の埋め込みモデルを選択して画像を含む検索ができるとリリースで報告されています(執筆時点・[Dify releases](https://github.com/langgenius/dify/releases))。一方、ChatGPTなどの汎用AIチャットに画像を貼って読ませるのは、前述のとおりマルチモーダルLLMの機能であって、社内文書全体を検索して答えるにはRAG側の構築が別途必要です。ツールの対応状況はアップデートで頻繁に変わるため、導入判断の際は必ず各公式ドキュメントで最新の仕様を確認してください。具体的な構築手順は本記事の範囲を超えるため、別記事で扱います。

    自社の文書はテキストで足りるのか、図面・スキャンまで読ませる構成が要るのか——この見立てから相談したい場合は、PolarisXにお声がけください。私たちは、自社開発の高精度RAG技術を搭載した司令塔AI社員「[Polaris AI](https://polarisx.ltd/)」を提供しており、約20のAIエージェントと共有ナレッジを自社で毎日運用する当事者として、「いまの文書構成でAIはどこまで答えられるか」「先にやるべきはデータ整備か、仕組みの導入か」の診断からお手伝いします。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ![自社にマルチモーダルRAGが必要かを3段階で判定する信号機式の図。テキストで完結するなら通常のRAGで十分、図やスキャンが多いが質が未整備ならまずデータの前処理、非テキスト依存が高く通常のRAGで壁に当たっているならマルチモーダルRAGの検討へ進むことを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multimodal-rag-fig5-signal-adoption-check.png)

    ## 用語の要点

    – **マルチモーダルRAG**=画像・図表・音声まで検索対象に含め、根拠つきで答えるRAGの拡張手法。複数のデータ形式を理解できる「モデル」であるマルチモーダルAI・LLMとは別物で、そのモデルを部品として使う「仕組み」を指す。
    – **効くのは、業務の根拠が図面・写真・スキャンなど非テキスト資料に偏っている会社**。重要情報がテキストで完結しているなら、通常のRAGとナレッジのテキスト構造化が先で、マルチモーダル化は過剰投資になりうる。
    – **精度を決めるのはデータ側の質**(解像度・キャプション・図と本文の紐づけ)。費用やツールの対応状況は変化が速いため、執筆時点の報告値・仕様として幅で捉え、導入時に一次情報で確認する。

    ## よくある質問

    **Q. マルチモーダルRAGとマルチモーダルAI(マルチモーダルLLM)は同じものですか?**
    別物です。マルチモーダルAI・マルチモーダルLLMは、テキスト・画像・音声など複数のデータ形式を理解できるAIモデルそのものを指します。マルチモーダルRAGは、そのモデルを部品として使い、社内の大量の資料から質問に関係する箇所を検索して根拠つきで答える仕組み全体のことです。画像を1枚貼って読ませることと、何千ファイルから該当の図を探し出して答えることの間には、検索・索引化という別の技術が挟まっています。

    **Q. マルチモーダルRAGのメリット・デメリットは何ですか?**
    メリットは、テキスト検索では拾えなかった図面・写真・スキャン書類・図表の中身をAIの回答の根拠にできることです。デメリットは、非テキストデータの解析工程が増えるぶん、開発難易度・計算資源・費用が通常のRAGより大きくなると報告されていること、そして元データの質(解像度・キャプション)が低いと精度が出ないことです。重要情報がテキストで完結している会社には、過剰投資になる可能性があります。

    **Q. マルチモーダルRAGの導入費用はどれくらいかかりますか?**
    構成による幅が大きく、単一の相場はありません。執筆時点の報告値では、SaaS型で月額数万円程度から、小規模構築で100万〜500万円程度、大規模な構築・運用で年間数百万〜数千万円規模とされています。マルチモーダル対応は解析工程が増えるぶんテキストのみの構成より費用が上振れする傾向がありますが、具体的な倍率を示す一次情報は確認できていません。いずれも二次情報の目安です。費用を左右するのは対象範囲の絞り込みなので、1部門・1用途で小さく検証してから広げる進め方をおすすめします。

    **Q. DifyやChatGPTでマルチモーダルRAGは使えますか?**
    Difyは、v1.11.0以降でナレッジベースのマルチモーダル対応が追加され、Vision対応の埋め込みモデルを選ぶことで画像を含む検索ができると報告されています(執筆時点)。ChatGPTなどの汎用AIチャットは画像を貼れば読めますが、それはマルチモーダルLLMの機能であり、社内文書全体を検索して答えるにはRAG側の構築が別途必要です。ツールの対応状況はアップデートで変わるため、導入前に必ず公式ドキュメントで最新仕様を確認してください。

    **図面・写真・スキャン文書まで含めて「AIに聞ける会社」にしたい方へ** — PolarisXは、社内ナレッジベースの構築と、それを読んで働く司令塔AI社員「Polaris AI」(自社開発の高精度RAG技術を搭載)を提供しています。約20のAIエージェントと共有ナレッジを自社で毎日運用する立場から、「いまの文書はAIが読める形か」「先に整備すべきはどこか」の見極めからご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご連絡ください。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧いただけます。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(複数部門で約20のAIエージェント)の運用実務に携わるメンバーで構成しています。自社の社内ナレッジを、全AIエージェントが参照する共有の一次ソース(RAGソース)として毎日運用しており、本記事はその現場で得た「AIが読める形」の判断基準をもとに、マルチモーダルRAGという技術概念を導入判断の視点でまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(Lewis et al., 2020)](https://arxiv.org/abs/2005.11401)
    – [Learning Transferable Visual Models From Natural Language Supervision(CLIP・Radford et al., 2021)](https://arxiv.org/abs/2103.00020)
    – [ColPali: Efficient Document Retrieval with Vision Language Models(Faysse et al., 2024)](https://arxiv.org/abs/2407.01449)
    – [Get multimodal embeddings(Google Cloud Documentation)](https://cloud.google.com/vertex-ai/generative-ai/docs/embeddings/get-multimodal-embeddings) — 2026年4月のGoogleブランド再編で「Gemini Enterprise Agent Platform」表記への移行が進行中(本URLはリダイレクトで到達可)
    – [Dify Releases v1.11.0(langgenius/dify・GitHub)](https://github.com/langgenius/dify/releases/tag/1.11.0) — ナレッジベースのマルチモーダル対応(”Multimodal Knowledge Base”)を一次リリースノートで確認済み
    – [生成AIの導入にかかる費用相場とは?(intra-mart)](https://www.intra-mart.jp/im-press/useful/cost-ai) — 導入費用レンジの出典
    – 本文の導入費用・活用事例に関する数値は、執筆時点(2026年7月)の二次情報による報告値です。個別の見積・仕様は各社公式情報をご確認ください。

  • マルチAIエージェントとは?仕組み・メリット・限界を解説

    マルチAIエージェントとは?仕組み・メリット・限界を解説

    マルチAIエージェントとは、複数のAIエージェントがそれぞれ役割を分担し、司令塔(オーケストレーター)の采配のもとで連携しながら、一つの目的を遂行する仕組みのことです。人間の組織にたとえるなら、「何でもできる一人の超人」ではなく、「得意分野の違うメンバーをマネージャーが束ねるチーム」に当たります。

    この言葉が分かりにくいのは、似た用語が入り乱れているからです。学術用語の「マルチエージェントシステム(MAS)」、制度文書に登場する「エージェンティックAI」、そしてAutoGenやCrewAIといったフレームワーク名——どれも同じ話の別の側面を指しています。さらに「1つのAIに複数の指示を出すこと」と混同されたり、「エージェントは多いほど良い」と誤解されたりもします。まずは定義と境界線を揃えましょう。

    > **一言でいうと**:マルチAIエージェントとは、役割の違う複数のAIエージェントを、司令塔が束ねて連携させる”AIのチーム”です。1体のAIに全部を任せるのではなく、仕事を分解し、専門のAIが分担して進めます。
    >
    > **マルチAIエージェントをめぐる3つの誤解**
    > 1. 「1つの万能AIに複数の指示を並べて出すこと」だと思われがち — 実際は指示の数ではなく、役割を持ったAI同士が連携する”構成”を指します。
    > 2. 「エージェントを増やすほど成果が上がる」と思われがち — 窓口の設計とナレッジ共有が伴わなければ、複雑さだけが増えます。
    > 3. 「専門の開発チームがないと作れない」と思われがち — フレームワークやサービスの成熟で、小さく始める道が広がっています。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— AI社員「Polaris AI」の開発と、自社のAI社員組織(3部門・約20のAIエージェント)の運用に携わるメンバーが執筆しています。

    ## マルチAIエージェントとは — 複数のAIが役割分担して連携する「チーム」

    マルチAIエージェントとは、複数のAIエージェントが役割を分担し、連携しながら一つの目的を遂行する仕組みです。学術的には「マルチエージェントシステム(MAS)」と呼ばれてきた考え方を、大規模言語モデル(LLM)ベースのAIエージェントで実現したものを指します。構成の基本は、依頼を受けて仕事を分解し各エージェントに割り振る**オーケストレーター(司令塔)**と、割り振られた仕事を実行する**ワーカー(実行担当)**の組み合わせです。たとえば「競合を調べて提案書のたたきを作る」という依頼なら、調査担当・執筆担当・チェック担当のエージェントが分担し、司令塔が結果を統合して返します。ポイントは、AIの「数」ではなく「分担と采配の構成」を指す言葉だという点です。

    ![マルチAIエージェントの基本構成を示す階層図。頂点に司令塔(オーケストレーター)、その下に調査・作成・チェックなど役割の違うワーカーエージェントが並び、土台に全員が参照する共有ナレッジベースがあることを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multi-ai-agent-fig1-hierarchy-orchestrator-team.png)

    ### シングルエージェント(単体のAIエージェント)との違い

    シングルエージェントは、1体のAIが調査も作成も確認も、すべての工程を一人で担う構成です。単一の業務なら十分に機能しますが、工程が長く複雑になるほど、1体が抱える文脈(作業記憶)が膨らみ、途中の抜けや品質のばらつきが出やすくなります。マルチAIエージェントは、工程を役割に切り分けて別々のエージェントに持たせることで、それぞれが自分の専門に集中できるようにした構成です。ChatGPTのエージェントモードのような単体ツールの自律実行はシングルエージェントの代表例で、マルチはその”チーム化”に当たります。違いの本質は「AIが1体か複数か」という数ではなく、**仕事を分解して分担させる設計があるかどうか**です。だからこそ、後述するとおり「増やせば良くなる」とは限りません。

    ### なぜ今注目されるのか

    背景は2つあります。第一に、生成AIが「質問に答える」段階から「目的を与えると自律的にタスクを連鎖実行する」段階へ進んだことです。総務省・経済産業省の「AI事業者ガイドライン」も2026年3月の第1.2版で、自律的にタスクを実行するAIシステムを「AIエージェント」と定義し、複数のAIエージェントが連携して動く「エージェンティックAI」という関連概念に言及しました([AI事業者ガイドライン](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html))。第二に、単体のAIエージェントを導入した企業が「1つの業務は速くなったが、業務全体はカバーできない」という壁に当たり始めたことです。Microsoftが複数エージェントのオーケストレーション設計パターンを公式ドキュメントとして整理し([Microsoft Learn](https://learn.microsoft.com/ja-jp/azure/architecture/ai-ml/guide/ai-agent-design-patterns))、Anthropicが自社製品のマルチエージェント構成を公開するなど、主要ベンダーの設計知見が出揃ってきたことも、実務での検討を後押ししています。

    ## マルチAIエージェントの仕組み — オーケストレーター・ワーカー型を中心に

    マルチAIエージェントの動きは、「分解→割り当て→実行→統合」の流れで説明できます。利用者が司令塔(オーケストレーター)に依頼を出すと、司令塔は依頼をタスクに分解し、それぞれを適したワーカーエージェントへ割り当てます。ワーカーは並行して作業を進め、結果を司令塔へ返し、司令塔が統合・整形して利用者に届けます。人間はこの最終出力を確認し、必要なら修正を指示します。重要なのは、この連携が成り立つ前提として、各エージェントが同じ社内情報を参照できる**共有ナレッジ**があることです。分担の設計と情報の共有——この2つが揃って初めて、複数のAIは”バラバラのツール”ではなく”一つのチーム”として機能します。

    ![オーケストレーターがタスクを分解しワーカーに割り振り、結果を統合して人が確認するまでの5ステップの流れ図。依頼、タスク分解、並列実行、結果の統合、人の確認・修正の順で進むことを示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multi-ai-agent-fig2-steps-orchestration-flow.png)

    ### 代表的な構成パターン

    もっともよく紹介されるのが、ここまで述べた**オーケストレーター・ワーカー型**(解説記事では「マネージャー型・ワーカー型」とも呼ばれます)です。司令塔が全体を采配するため、利用者の窓口が一つで済み、統制も取りやすい構成です。このほかMicrosoftの設計ガイドでは、工程を順番に受け渡す**逐次(シーケンシャル)型**、独立した作業を同時に走らせる**並行(コンカレント)型**、複数エージェントが議論する**グループチャット型**、担当を切り替えていく**ハンドオフ型**などのパターンが整理されています([Microsoft Learn](https://learn.microsoft.com/ja-jp/azure/architecture/ai-ml/guide/ai-agent-design-patterns))。実務では、これらを純粋に使い分けるというより、オーケストレーター・ワーカー型を軸に、工程の性質に応じて逐次・並行を組み合わせる形が現実的です。

    ### エージェント間の連携方法 — タスクの分解・統合と共有ナレッジ

    連携の質を決めるのは、(1)タスクの分解と指示の明確さ、(2)結果の統合、(3)共有ナレッジの3点です。司令塔からワーカーへの指示が曖昧だと、ワーカー同士の作業が重複したり、必要な観点が抜けたりします。Anthropicは自社の調査機能をオーケストレーター・ワーカー型で構築した経験から、サブエージェントへの指示に目的・出力形式・使うツール・作業範囲を明示しないと、重複作業や抜けが起きると報告しています([Anthropic](https://www.anthropic.com/engineering/built-multi-agent-research-system))。そして見落とされがちなのが共有ナレッジです。各エージェントが自社の用語・製品・過去の経緯を同じ情報源から参照できないと、同じ質問に別々の答えを返す”分断”が起きます。私たちPolarisXの司令塔AI社員「Polaris AI」も、司令塔+専門AI社員の全員が同じ社内ナレッジベースを参照する構成を前提にしています。

    ## マルチエージェント導入のメリットとデメリット・課題

    マルチエージェント化のメリットは、業界解説で共通して「並列処理による効率化」「専門特化による精度向上」「相互検証による信頼性向上」の3点に整理されます。一方でデメリットも裏表の関係にあり、「構成が複雑になり挙動を追いにくくなる」「処理量・コストが増える」「エージェント間で情報が分断する」が代表的な課題です。つまりマルチエージェントは、効果を大きくする仕組みであると同時に、管理の難しさも大きくする仕組みです。同じ構成でも、設計と運用が整っているかどうかで、メリットにもリスクにも転びます。導入判断では「効果が出るか」だけでなく「複雑さを管理できるか」を同じ重みで見る必要があります。

    ### メリット — 並列処理・専門特化・相互検証

    第一に**並列処理**。独立した作業を複数のエージェントが同時に進めるため、調査や資料作成のような「幅のある仕事」が速くなります。第二に**専門特化**。各エージェントが役割に絞った指示・知識を持つことで、1体の万能エージェントより深く網羅的な出力が得やすくなります。第三に**相互検証**。作る担当と確認する担当を分けることで、誤りに気づける構造を仕組みとして持てます。効果の大きさを示す一次報告としては、Anthropicが自社の調査タスク評価において、司令塔+複数サブエージェントの構成が単体エージェント構成の性能を90.2%上回ったと公表しています([Anthropic](https://www.anthropic.com/engineering/built-multi-agent-research-system))。ただしこれは同社の社内評価での報告値であり、どんな業務でも同じ効果が出るという意味ではありません。効果が出るのは、後述するとおり「分担する価値のある複雑な業務」に当てたときです。

    ![マルチエージェントの3つのメリットが、設計・運用の整い方しだいで課題に裏返ることを示す対応ヒートマップ。並列処理・専門特化・相互検証の各行について、設計が整っている場合は効率化・精度向上・信頼性向上に効き、整っていない場合はコスト膨張・情報の分断・責任の曖昧化という課題に転じることを濃淡で示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multi-ai-agent-fig3-heatmap-merit-flipside.png)

    ### デメリット・課題 — 複雑性・コスト・情報分断

    裏返しの課題は3つです。第一に**複雑性の増大**。エージェント間のやり取りが多岐にわたるほど内部の挙動が追いにくくなり、「何がどこで間違ったか」を特定しにくくなると複数の解説で共通して指摘されています。だからこそ、各エージェントの動作ログを収集し、あとから監査できる仕組みを最初から用意することが推奨されます。第二に**コスト**。エージェントが増えるほど処理量は増えます。前述のAnthropicの報告でも、マルチエージェント構成は通常のチャット利用の約15倍のトークン(処理量)を消費したとされており、成果がコストに見合う業務を選ぶ必要があります。第三に**情報の分断**。共有ナレッジが整っていないと、エージェントごとに参照する情報がずれ、出力に矛盾が生じます。いずれも「マルチにすれば自動的に良くなる」わけではないことを示す課題です。

    ## マルチエージェントの活用事例と代表的なフレームワーク

    マルチAIエージェントの活用は、業界の解説・事例報告では大きく「コンテンツ制作」「社内問い合わせ・ナレッジ対応」「バックオフィス業務」の3類型で語られることが多く、これに「調査・リサーチ」を加えた4つが典型です。共通するのは、複数の工程や観点に分かれ、1体のAIでは抱えきれない”幅”のある業務だという点です。ここでは特定企業の事例を断定的に紹介する代わりに、報告されている類型と、私たち自身が日次で運用している実例を紹介します。なお、この類型のどれに当たるかを見立てることが、次の章で述べる「自社に必要かどうか」の判断の入口になります。

    ### 活用事例の類型 — コンテンツ制作・社内問い合わせ・バックオフィス

    **コンテンツ制作**は、企画→執筆→校閲→画像制作という工程分担がそのままエージェントの役割分担になる領域です。実例として私たちPolarisXは、この記事を含む自社ブログやSNS発信を「戦略担当・執筆担当・編集担当・画像担当」の専門AI社員が分担し、司令塔が束ねる形で日次運用しています。**社内問い合わせ・ナレッジ対応**は、質問の分類→社内情報の検索→回答案の作成→根拠の確認を分担する型で、問い合わせが特定の担当者に集中している会社ほど効きます。**バックオフィス**は、経理・人事などで書類の読み取り→照合→整理→下書き作成を分担する型です。**調査・リサーチ**は、Anthropicが公開した構成のように、複数の調査エージェントが並行して情報を集め、司令塔が統合する型が代表例です。

    ![マルチエージェントの活用類型を整理した比較表の図。コンテンツ制作・社内問い合わせ対応・バックオフィス・調査リサーチの4類型それぞれについて、分担の形と効く理由を並べて示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multi-ai-agent-fig4-table-usecase-roles.png)

    ### 代表的なフレームワーク(名称の紹介まで)

    開発の現場では、マルチエージェントを構築するためのフレームワークとして **AutoGen(Microsoft)・CrewAI・LangGraph・MetaGPT** などの名前がよく挙がります。動向として押さえておきたいのは、Microsoftが AutoGen と Semantic Kernel を統合した後継フレームワーク「Microsoft Agent Framework」を公式に案内しており、新規開発はそちらへ移行する流れにあることです([Microsoft Dev Blogs](https://devblogs.microsoft.com/agent-framework/semantic-kernel-and-microsoft-agent-framework/))。ただし、経営者・DX推進担当の意思決定として先に決めるべきは「どのフレームワークを使うか」ではありません。フレームワーク選定はエンジニアリングの各論であり、その前段の「そもそも自社の業務にマルチエージェントが必要か」「誰がどう運用するか」が決まっていなければ、どれを選んでも成果は出ません。本記事では名称の紹介にとどめ、次の章でその前段の判断を扱います。

    ## 「増やすほど良い」わけではない — マルチAIエージェントの限界と注意点

    マルチAIエージェントが効かない場面をはっきりさせておきます。効かないのは、(1)業務が単一の定型作業で分担する価値がない場合、(2)エージェントに参照させる社内ナレッジが整っていない場合、(3)出力を確認・改善する人を置けない場合です。この3つのどれかに当てはまる状態でエージェントの数だけ増やすと、効果よりも先に複雑さとコストが増えます。マルチエージェントは「シングルの上位互換」ではなく、複雑な業務を分担で解くための構成であり、分担する価値のない業務にはシングルエージェントのほうが向きます。導入の順番としても、いきなりチームを組むのではなく、効く業務を見極めてから広げるのが安全です。

    ![マルチエージェント化を進めて良いかを3段階で判定する信号図。青は分担する価値のある複雑な業務と共有ナレッジ・確認体制が揃った進めて良い状態、黄はログ・監査の仕組みづくりを先に行う条件つきの状態、赤は窓口設計とナレッジ整備が先でマルチ化はまだ早い状態を示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/multi-ai-agent-fig5-signal-scale-readiness.png)

    ### 複雑性が増すほど運用・デバッグが難しくなる

    エージェントが増えるほど、間違いの原因を特定する難易度が上がります。シングルエージェントなら「AIの回答が違う」で済んだ問題が、マルチでは「司令塔の分解が悪かったのか、ワーカーの実行が悪かったのか、統合で壊れたのか」を切り分ける必要があります。解説・設計ガイドの多くが、エージェントごとの動作ログの収集と、あとから挙動を監査できる仕組みを最初から作ることを推奨しているのはこのためです。運用面では、「どのエージェントが何を担当し、誰がその出力に責任を持つか」という分担表を人間側が持っておくことも欠かせません。ログと分担表がないままエージェントを増やすことは、記録のない組織に人を増やすことと同じで、規模が複雑さにそのまま変換されてしまいます。

    ### 社内ナレッジが共有されないと情報が分断する

    マルチエージェントの前提は、全エージェントが同じ社内情報を参照できることです。エージェントごとに別のツール・別のデータを見ている状態では、営業担当エージェントと問い合わせ担当エージェントが同じ製品について違う説明をする、といった分断が起きます。これはエージェントの賢さの問題ではなく、参照する情報源の設計の問題です。実務的には、マルチ化の前に「社内の情報がどこにあり、AIに何を参照させるか」を整理する——つまり共有ナレッジベースの整備が先行タスクになります。逆に言えば、ナレッジ整備は1体目のエージェントから効く投資であり、ここが整っている会社ほど、あとからエージェントを増やす拡張がスムーズに進みます。

    ### 現場でよく見る誤解と見極め

    私たちPolarisXは、マーケティング・財務・営業の3部門・約20のAIエージェントからなるAI社員組織をClaude(Anthropic)上に構築して自社で日次運用し、同じ構成を司令塔AI社員「Polaris AI」として提供もしている当事者です。その現場で繰り返し見るのが、「うまくいかないのはエージェントが足りないからだ」という誤解です。実際には逆で、うまくいっていない状態で数を増やすと、窓口が分裂し、参照する情報がずれ、確認しきれない出力が増えます。私たちが使う見極めはシンプルです——**エージェントを増やす前に、窓口設計(誰に頼めば良いかが一つに決まっているか)とナレッジ共有(全員が同じ情報を参照できるか)を先に整える**。そして反証のサインも決めています。**エージェントを増やしたのに、タスクの手戻りや二重対応がむしろ増えたなら、それは数ではなく設計を見直すべきサインです**。

    **自社の業務がマルチエージェントに向くか、それとも窓口設計・ナレッジ整備が先かを見極めたい方は、AI社員組織を自社で運用するPolarisXに、まずは無料相談としてお問い合わせください([contact@polarisx.ltd](mailto:contact@polarisx.ltd))。**

    ### 中小企業・情シス不在ならどこから始めるか

    従業員30〜100名で専任の情シスがいない会社なら、最初からエージェントのチームを組む必要はありません。現実的な順番は、(1)問い合わせや資料作成など、属人化して負荷が集中している1業務に1体のエージェントを当てて効果を確かめる、(2)その過程で社内ナレッジを整備する、(3)対象業務が複数部門に広がり、複数のAIツールの窓口がバラバラになってきた段階で、司令塔に束ねるマルチ構成を検討する——という3段階です。マルチエージェントは自社で一から開発する以外に、司令塔+専門AI社員の構成をサービスとして導入する選択肢もあり、開発チームの有無だけで諦める必要はありません。大事なのは、”チームを組む価値のある複雑さ”が自社の業務に育ってから広げることです。

    ## 用語の要点

    – **マルチAIエージェントとは**、役割の違う複数のAIエージェントを司令塔(オーケストレーター)が束ね、連携させて一つの目的を遂行させる構成。AIの「数」ではなく「分担と采配の設計」を指す。
    – **メリットとデメリットは裏表**:並列処理・専門特化・相互検証で効果が大きくなる一方、複雑性・コスト・情報分断も大きくなる。設計と運用が整っているかで、どちらに転ぶかが決まる。
    – **順番が肝心**:窓口設計と共有ナレッジの整備が先、エージェントを増やすのは後。手戻りや二重対応が増えたら、数ではなく設計を見直すサイン。

    ## よくある質問

    **Q. マルチエージェントとシングルエージェント(単体のAIエージェント)は何が違いますか?**
    シングルエージェントは1体のAIがすべての工程を担い、マルチエージェントは工程を役割に分けて複数のAIが分担します。違いの本質は数ではなく、「仕事を分解して割り当てる司令塔(オーケストレーター)の設計があるか」です。単一の定型業務ならシングルで十分で、複雑で幅のある業務ほどマルチの分担が効きます。

    **Q. マルチAIエージェントを導入するメリットは何ですか?**
    業界解説で共通して挙がるのは、(1)独立した作業を同時に進める並列処理による効率化、(2)役割に絞ることによる出力の深さ・網羅性の向上、(3)作る担当と確認する担当を分ける相互検証による信頼性向上の3点です。Anthropicは自社の調査タスク評価で、マルチ構成が単体構成を90.2%上回ったと報告しています(社内評価の報告値です)。

    **Q. マルチAIエージェントのデメリット・課題は何ですか?**
    代表的な課題は、(1)構成が複雑になり「何がどこで間違ったか」を追いにくくなること、(2)処理量が増えコストが膨らむこと(Anthropicは通常チャットの約15倍のトークン消費を報告)、(3)共有ナレッジが整っていないとエージェント間で情報が分断することの3つです。動作ログの収集と監査の仕組みを最初から用意することが、実運用の前提になります。

    **Q. マルチAIエージェントを作るフレームワークにはどんなものがありますか?**
    AutoGen(Microsoft)・CrewAI・LangGraph・MetaGPT などがよく挙げられます。なお、Microsoftは AutoGen と Semantic Kernel を統合した後継の「Microsoft Agent Framework」を公式に案内しており、新規開発はそちらへ移行する流れです。ただし経営判断としては、フレームワーク選定より先に「自社の業務にマルチエージェントが必要か」を見極めるのが順番です。

    **Q. マルチAIエージェントとエージェンティックAIは同じ意味ですか?**
    重なる概念ですが、視点が違います。エージェンティックAIは「AIが自律的に判断・行動する」という性質・方向性を指す広い言葉で、総務省・経済産業省の「AI事業者ガイドライン」第1.2版では複数のAIエージェントが連携して動く概念として言及されています。マルチAIエージェントは、その性質を「複数のエージェントの分担と連携」という具体的な構成で実現する仕組みを指します。

    **マルチエージェントの前に、まず自社の見極めから** — PolarisXは、司令塔AI社員「Polaris AI」(オーケストレーター+専門AI社員の構成)の開発と、自社AI社員組織の運用を手がける当事者として、「分担する価値のある業務があるか」「共有できるナレッジがあるか」の見極めからご一緒します。まずは無料相談として [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へご連絡ください。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧いただけます。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社のAI社員組織(マーケティング・財務・営業の3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。本記事は、マルチエージェント構成の設計・社内ナレッジ整備・日次運用の現場で得た判断基準を、教科書的な定義解説に加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [AI事業者ガイドライン(第1.2版)(総務省・経済産業省、2026年)](https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html)
    – [AI エージェント オーケストレーション パターン(Microsoft Learn / Azure Architecture Center)](https://learn.microsoft.com/ja-jp/azure/architecture/ai-ml/guide/ai-agent-design-patterns)
    – [How we built our multi-agent research system(Anthropic、2025年)](https://www.anthropic.com/engineering/built-multi-agent-research-system)
    – [Semantic Kernel and Microsoft Agent Framework(Microsoft Dev Blogs、2025年)](https://devblogs.microsoft.com/agent-framework/semantic-kernel-and-microsoft-agent-framework/)

  • AIヘルプデスクとは?仕組み・費用相場・失敗しない選び方を解説

    AIヘルプデスクとは?仕組み・費用相場・失敗しない選び方を解説

    AIヘルプデスクとは、社内外からの問い合わせ対応の一次窓口をAIが担う仕組みのことです。従業員や顧客からの「パスワードを忘れた」「この手続きはどこに申請するのか」といった質問に、AIがFAQ・マニュアルなどの社内ナレッジをもとに自動で答え、答えきれないものだけを人へ引き継ぎます。

    なお、この記事は「AIヘルプデスク」という仕組み・カテゴリ全体を扱う定義記事です。個別チャネルの構築手順は、[FAQチャットボットの作り方](/blogs/faq-chatbot)と[社内チャットボットの作り方](/blogs/internal-chatbot)で詳しく扱います。具体的なツール・ベンダーの比較は別の記事に譲ります。

    この言葉が分かりにくいのは、「チャットボット」や「FAQシステム」と重なって見えるからです。しかも検索で出てくる記事の多くはベンダーが書く「おすすめ◯選」で、仕組みの説明はそこそこに製品紹介へ進みます。その結果、「チャットボットと何が違うのか」「入れれば本当に問い合わせは減るのか」という肝心の疑問が残ったままになりがちです。そこでこの記事は、仕組み(RAG)・チャットボットとの違いと種類・効果・費用相場・効かない場面までを一続きで整理し、読み終わった時点で「自社に必要か」を自分で判断できる状態を目指します。

    > **一言でいうと**:AIヘルプデスクとは、FAQ・マニュアルといった社内ナレッジをAIが参照し、問い合わせ対応の一次窓口を務める仕組みです。成否を分けるのはツールの性能よりも、「AIが参照するナレッジが整っているか」です。
    >
    > **先に正しておきたい誤解3つ**
    > 1. **チャットボットを入れることと同じ** — チャットボットは、AIヘルプデスクを構成する部品の一つです。仕組み全体には、ナレッジの整備・有人への引き継ぎ・運用改善までが含まれます。
    > 2. **導入すれば問い合わせがすぐゼロになる** — AIが担えるのは定型的・反復的な問い合わせの一次対応です。複雑な個別対応は人に残り、ゼロにはなりません。
    > 3. **FAQやマニュアルがなくてもAIが何でも答えてくれる** — 生成AIは「参照できる情報」の範囲でしか正確に答えられません。ナレッジが未整備のままでは、誤答が増えるだけです。

    **執筆**: PolarisX 編集部(AI活用の実務者チーム)— 社内ナレッジベースとRAGで接続する司令塔AI社員「Polaris AI」を開発し、自社でも3部門・約20のAIエージェントからなるAI社員組織を内製運用するメンバーが執筆しています。

    ## AIヘルプデスクとは — AIが問い合わせの一次対応を担う仕組み

    AIヘルプデスクとは、社内外からの問い合わせに対して、AIが一次対応を自動で担う仕組みです。具体的には、①従業員・顧客からの質問を受け付ける ②FAQ・マニュアル・社内文書といったナレッジをAIが検索する ③見つけた情報を根拠に回答を生成して返す ④AIで解決できない質問は担当者へ引き継ぐ(エスカレーション)——という4つの動きで構成されます。対象になるのは、情報システム部門への社内問い合わせ(パスワード再設定・ツールの使い方)から、人事・総務への手続き確認、顧客からのカスタマーサポートまで幅広く、24時間365日対応できることと、回答が担当者個人に依存しないことが、人手のヘルプデスクとの大きな違いです。

    ![AIヘルプデスクの仕組みを4ステップで示した図。従業員や顧客からの問い合わせを受け付け、AIがFAQ・マニュアルなど社内ナレッジを検索し、見つけた根拠をもとに回答を生成し、解決できない質問だけを担当者へエスカレーションする流れ](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig1-steps-rag-flow.png)

    ### 仕組みの中核はRAG — 社内文書を「検索してから」答えるAI

    多くのAIヘルプデスクの中核にあるのが、RAG(Retrieval-Augmented Generation:検索拡張生成)と呼ばれる仕組みです。RAGとは、生成AIが回答を作る前に、外部のナレッジ(社内文書・FAQ・マニュアル)を検索し、見つかった記述を根拠として回答を組み立てる技術で、原典は[Lewis らの2020年の論文](https://arxiv.org/abs/2005.11401)、平易な解説は[AWSの公式ドキュメント](https://aws.amazon.com/jp/what-is/retrieval-augmented-generation/)にあります。ChatGPTのような生成AIは、そのままでは自社の規程・手順・製品仕様を知りません。RAGを挟むことで「自社の文書に書いてあること」を根拠に答えられるようになり、根拠のない、もっともらしい誤答(ハルシネーション)を抑えられます。

    従来のシナリオ型チャットボット(あらかじめ用意した分岐やQ&Aへの一致で答えるタイプ)との違いも、このナレッジ参照の有無にあります。シナリオ型は想定質問から外れると答えられませんが、RAG型は言い回しが違っても文書から該当箇所を探して答えられます。ここから、この記事全体を貫く重要な含意が導けます。**RAG型AIヘルプデスクの賢さは、AIモデルの性能よりも、参照できるナレッジの質と量で決まる**ということです(詳しくは後述の「効かない場面・限界」で扱います)。

    ### なぜいま需要が増えているのか

    背景の一つは、ヘルプデスク業務の負荷が定量的に裏づけられてきたことです。キヤノンマーケティングジャパンが情報システム部門の担当者100名(従業員300〜1,000名未満の企業)を対象に実施した[2025年版の実態調査](https://prtimes.jp/main/html/rd/p/000001291.000013943.html)では、**77.0%が社内ヘルプデスク業務に課題を実感**(前年比12.2ポイント増)し、**74.0%がヘルプデスク業務を外部に委託している**(前年比28.6ポイント増)と報告されています。同調査では、効率化のために生成AIを活用・検討する担当者が約4人に1人いる一方、その約6割が「どのサービスが良いのかわからない」と答えたことも報告されており、関心と判断基準のギャップがうかがえます。

    もう一つの背景は、生成AI・RAGの実用化で「言い換えに強い自動応答」が現実的な価格帯まで降りてきたことです。従業員数十名の会社では、専任の情シスがおらず、総務やITに詳しいメンバーが兼任で一次対応を担っているケースが多くあります。その割り込み対応が本来業務を止めているなら、規模の大小にかかわらず検討する意味のある仕組みになっています。

    ## AIヘルプデスクとチャットボットは何が違うのか — 混同されがちな概念の整理

    AIヘルプデスクとチャットボットの関係は、「業務全体の仕組み」と「それを構成する自動応答ツール」の関係です。AIヘルプデスクは、問い合わせの受付からナレッジの参照・回答の生成・有人への引き継ぎ・回答ログをもとにしたナレッジの更新までを含む、問い合わせ対応業務の仕組み全体を指します。一方チャットボットは、その入口に置かれる自動応答の部品の一つで、チャット形式で質問に答える機能を担います。したがって実務での問いは「チャットボットかAIヘルプデスクか」の二者択一ではなく、「自動応答の部品だけを置くのか、引き継ぎと運用改善まで含む仕組みとして組むのか」です。部品だけを置いた導入が形骸化しやすい理由も、この差にあります。

    ![AIヘルプデスクとチャットボットの包含関係を示した図。問い合わせ対応業務全体の仕組みであるAIヘルプデスクの中に、チャットボット・FAQ検索・有人への引き継ぎ・ナレッジ更新が部品として含まれることを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig2-venn-chatbot-boundary.png)

    なお、チャットボットという技術そのもの(種類・作り方・活用範囲)の深掘りは、ヘルプデスク文脈に限らない大きなテーマなので別記事に譲ります。

    ### タイプで分ける — 誰向けか × どの形式か

    AIヘルプデスクは「誰の問い合わせに答えるか」と「どんな形式で答えるか」の2軸で整理すると選びやすくなります。

    | 分類軸 | タイプ | 主な用途 |
    |—|—|—|
    | 誰向けか | **社内向け(従業員向け)** | 情シス・人事・総務への問い合わせ対応。SlackやTeamsに組み込む形が多い |
    | 誰向けか | **社外向け(顧客向け)** | Webサイトのサポート窓口・カスタマーサポートの一次対応 |
    | 形式 | FAQ検索特化型 | 整備済みFAQの検索・提示に強い。回答の正確性を重視する場面向き |
    | 形式 | 会話型(チャットボット型) | チャットで対話的に答える。言い換えに強い生成AI型が主流に |
    | 形式 | 音声対応型 | 電話の自動応答。コールセンター文脈で使われる |
    | 形式 | 専門領域特化型 | 経理・労務・ITなど特定領域の規程や手続きに特化 |

    最初の一巡目で試しやすいのは、**利用者とテーマを限定した、低リスクの社内向け定型FAQ**です。範囲を制御して精度と運用を検証しやすい一方、社内情報を扱う以上、権限と人への引き継ぎを先に設計する必要があります。結果を確認してから、誤答が売上・信頼に直結する社外向けへ広げます。想定質問の設計と回答方式の選定は[FAQチャットボットの作り方](/blogs/faq-chatbot)、社内での構築・定着は[社内チャットボットの作り方](/blogs/internal-chatbot)で手順を解説しています。

    ## 導入するとどんな効果があるか — 活用シーンと報告されている数字

    AIヘルプデスクを導入した企業からは、大きく4種類の効果が報告されています。①定型問い合わせの一次対応が自動化され、担当者の対応件数・対応時間が減る ②24時間365日応答できるため、利用者の「解決までの待ち時間」が短くなる ③回答が文書ベースになり、担当者ごとの品質差がなくなる ④問い合わせログが蓄積され、FAQ・マニュアルの改善点が見えるようになる——の4つです。ただし効果の大きさは、問い合わせに占める定型的な質問の割合と、参照するナレッジの整備度で大きく変わります。「導入すれば一律◯%削減できる」という数字は存在しないため、公開事例の数字は「その会社の条件での報告値」として読むのが正確です。

    ### 公開されている事例 — アサヒグループHDの例(2017年)

    早い時期の公開事例として、アサヒグループホールディングスは2017年7月、社内のOAヘルプデスク業務にAIを活用したシステムを導入すると[ニュースリリースで発表](https://www.asahigroup-holdings.com/newsroom/detail/20170713-0102.html)しています。発表によると、当時グループで使われていたシステム・ITツールは約300、関連する問い合わせは年間約72,000件にのぼる一方、電話8回線・オペレーター交代制(8時〜20時)での2016年の応答は半数の約36,000件にとどまっていました。AI導入の狙いは、24時間365日の自動応答による応答率の向上と、ヘルプデスク業務の効率化です。9年前の事例ですが、「人手の窓口は物理的に応答しきれる量に上限がある」「その上限をAIの一次対応で外す」という構図は、現在の生成AI型ヘルプデスクでもそのまま通用します。

    ![アサヒグループホールディングスが2017年に公表した社内ヘルプデスクの状況を示した図。年間約72,000件の問い合わせに対し電話8回線での応答は約36,000件と半数にとどまり、これを24時間365日対応のAIヘルプデスクで補う構図](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig3-bignumber-effect.png)

    近年もベンダー各社の導入事例ページでは、社内問い合わせの相当な割合をAIの一次対応で解決できた、有人対応の稼働を大きく減らせたといった報告が公開されています。ただしいずれも各社の問い合わせ構成・ナレッジ整備度という条件のうえでの報告値であり、削減率をそのまま自社に当てはめることはできません。見るべきは数字の大小よりも「どんな種類の問い合わせをAIに任せて、その数字に至ったか」です。

    ### 効果が出やすい問い合わせ・出にくい問い合わせ

    効果が出やすいのは、**定型的・反復的で、答えを文書化できる問い合わせ**です。パスワード再設定、経費精算・勤怠の手続き、社内ツールの初歩的な使い方、製品の仕様・料金に関する定番の質問などが典型で、この種の質問は「同じ答えを何度も人が繰り返している」状態なので、AIの一次対応に置き換える効果がそのまま出ます。逆に効果が出にくいのは、個別の状況判断や交渉を伴う問い合わせ、感情面のケアが重要なクレーム対応、前例のない障害対応です。これらは最初から人が受ける設計にし、AIには「どこへ引き継ぐか」の交通整理だけを任せるほうが、利用者の体験を損ないません。

    ## AIヘルプデスクの費用相場【執筆時点の目安】

    AIヘルプデスクの費用は、仕組みのタイプで水準が変わります。執筆時点(2026年7月)で複数の比較メディアが報告しているレンジを突き合わせると、シナリオ型は月額数千円〜5万円程度、AI搭載型(FAQ学習型)は月額10万〜50万円程度、生成AI・RAG型は月額15万〜50万円程度から——というのが一つの目安です。ただし料金は問い合わせ件数・利用人数・設置チャネル数・オプションで大きく動くため、「AIヘルプデスクの相場は◯円」という単一の答えは存在しません。見積もりで確認すべきは金額そのものよりも、「その金額に何が含まれ、何が含まれないか」、特にナレッジ整備の支援が範囲に入っているかどうかです。

    ### タイプ別の料金レンジ

    | タイプ | 仕組み | 月額の報告レンジ(執筆時点の目安) |
    |—|—|—|
    | シナリオ型 | 事前に用意した分岐・一問一答で応答 | 数千円〜5万円程度 |
    | AI搭載型(FAQ学習型) | 登録したFAQをAIが照合・検索して提示 | 10万〜50万円程度 |
    | 生成AI・RAG型 | 社内文書を検索し、根拠つきで回答を生成 | 15万〜50万円程度から |

    このレンジは、[NTT東日本のチャットボット費用解説](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)や[Tayoriの料金相場記事](https://tayori.com/blog/ai-chatbot-pricing/)など複数メディアの報告値を突き合わせた目安です。初期費用も無料〜100万円以上と幅が大きく、いずれも改定・条件で動くため、契約時は必ず個別見積もりで確認してください。

    ![AIヘルプデスクの料金水準をタイプ別のスケール帯で示した図。シナリオ型は月額数千円から5万円程度、AI搭載型は10万から50万円程度、生成AI・RAG型は15万から50万円程度からと、仕組みが高度になるほど価格帯が上がることを表す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig4-gauge-pricing.png)

    ### 費用に影響する要因と、費用対効果の考え方

    月額を動かす主な要因は、①問い合わせ件数・利用ユーザー数 ②有人チャット(オペレーター引き継ぎ)機能の有無 ③設置チャネル数(Webサイト・Slack・Teams・電話など)④生成AIの利用量に応じた従量課金 ⑤初期のFAQ整備・チューニング支援の有無——の5つです。特に生成AI・RAG型は、回答のたびにAIの処理コストがかかるため、問い合わせ量が多いほど従量部分が効いてきます。

    費用対効果は「置き換えられる対応時間」で見積もるのが実務的です。たとえば月200件の定型問い合わせに1件平均10分かかっているなら、月約33時間の対応工数が置き換え候補です。その工数の人件費と、対応が翌営業日に持ち越されることによる業務の停滞まで含めて、月額と比べます。この計算で月額に届かないなら、導入を急ぐ段階ではありません。

    ## 導入しても効かない場面・限界 — ナレッジの整備度が成否を分ける

    AIヘルプデスクが効かない場面には、はっきりした共通点があります。AIが参照するナレッジ(FAQ・マニュアル・社内文書)が「ない」「古い」「AIから読めない形になっている」ことです。RAGの仕組み上、AIは参照できた情報の範囲でしか正確に答えられません。ナレッジが未整備のまま導入すると、誤答や「分かりません」が増え、利用者がAIを信用しなくなって使われなくなり、結局もとの属人対応へ戻る——という形骸化をたどります。そしてこの失敗は、ツールを乗り換えても解決しません。原因がツール側ではなくナレッジ側にあるからです。この章では、限界が生まれる理由と、私たちが現場で使っている見極めの基準を示します。

    ### 回答精度は、ナレッジの質と量に依存する

    生成AI・RAG型の回答品質は「検索で正しい文書が見つかるか」「その文書に正しい答えが書いてあるか」の2段階で決まります。つまり、FAQが少ない・マニュアルが数年前のまま・情報がスキャンPDFやスクリーンショット、個人のチャットログに散在している——という状態では、どれほど高性能なツールを入れても、検索の段階で答えの材料が見つかりません。また、参照できる根拠がないときに生成AIがもっともらしい誤答(ハルシネーション)を返すリスクは、ナレッジが薄いほど高まります。AIヘルプデスクの検討は、ツール選定の前に「AIが読めるテキストとして答えが存在するか」の確認から始まります。ナレッジを貯める・整える仕組みづくりそのものは、ナレッジマネジメントの記事で深掘りします。

    ### 現場でよく見る失敗と、私たちの見極め

    私たちPolarisXは、司令塔AI社員「Polaris AI」を提供する側であると同時に、自社でも3部門・約20のAIエージェントに業務を任せ、社内ナレッジベースをその共有脳として運用しています。この運用で繰り返し確認しているのは、**AIの回答品質が目に見えて変わる瞬間は「モデルを替えたとき」ではなく「ナレッジを直したとき」だ**という事実です。エージェントが的外れな出力をしたときに原因をさかのぼると、行き着く先はほとんどの場合、参照先のドキュメントが古い・曖昧・そもそも書かれていない、のいずれかでした。

    だから、導入前の見極めとして私たちが使う基準はシンプルです。「**候補ツールの比較表を眺める前に、よくある問い合わせ上位20件の答えが、AIから読めるテキストとしてすでに存在するかを数える**」。半分も存在しないなら、先にやるべきはツール選定ではなくナレッジの棚卸しです。

    導入後の判定基準も先に決めておきましょう。導入から2〜3か月たっても、①有人への引き継ぎ(エスカレーション)率が下がらない ②同じ質問に対する誤答・的外れな回答が繰り返される——のであれば、それはツールの失敗ではなく、ナレッジ側が原因のサインです。このときの正しい打ち手は乗り換えの検討ではなく、問い合わせログを見てFAQを追記・更新することです。問い合わせが減らない原因の切り分けは、症状別の診断記事として別途詳しく扱います。

    ![AIヘルプデスクの運用が機能するか形骸化するかを、ナレッジ整備・エスカレーション設計・セキュリティ設計の3観点の状態で判定する信号図。各観点に機能する状態・条件つきの状態・形骸化する状態の3段階を示す](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig5-signal-pitfalls.png)

    ### エスカレーションとセキュリティは「最初に」決める

    限界を踏まえた設計として、導入時に必ず決めておくべきことが2つあります。1つ目はエスカレーション設計です。AIに答えさせない領域(人事評価・懲戒・機密性の高い契約など)と、AIで解決しなかったときの引き継ぎ先・引き継ぎ方法を先に決めます。ここが曖昧だと、利用者は「AIに聞いても結局たらい回しになる」と感じ、利用が定着しません。2つ目はセキュリティです。個人情報・機密情報を含む文書をAIの参照範囲に入れるか、入れる場合は誰の質問にどこまで答えてよいか(権限に応じた参照範囲)、入力内容がAIの学習に使われない設定・契約になっているかを確認します。この2つは後から直すほど手戻りが大きいため、ツール選定の要件として最初から含めることをおすすめします。

    ## 実務での見極め — 自社に必要か、どこから始めるか

    AIヘルプデスクが向いているのは、「同じ質問が繰り返し届いていて、その答えを文書化できる」組織です。見極めは、①問い合わせの量と内訳を把握する(月に何件・どんな内容か)②そのうち定型的な質問の割合を見る ③定型質問の答えになるナレッジの整備度を確認する——の3段階で行います。月に数十件以上の定型問い合わせがあり、FAQ・マニュアルがある程度存在するなら、効果が見込める段階です。逆に、問い合わせが少量で内容が毎回異なるなら、仕組みを作って維持する手間が効果を上回りやすいため、有人対応の改善や文書整備を先に進めるほうが合理的です。

    ![AIヘルプデスクが向いている組織と急がなくてよい組織の条件を並べて比較した図。定型問い合わせの量・ナレッジの整備度・一次対応の負荷などの条件ごとに、導入効果が見込める状態と先にやるべきことがある状態を対比する](https://cms.polarisx.ltd/wp-content/uploads/2026/08/ai-helpdesk-fig6-table-fit-check.png)

    ### 向いている企業・部署/急がなくてよい企業

    部署の単位で見ると、効果が出やすいのは情報システム・人事・総務・経理といった「社内から手続きの質問が集まる管理部門」と、定番の質問が多いカスタマーサポートです。会社の単位で見ると、従業員30〜100名で専任の情シスがいない会社は、実は有力な候補です。この規模では、ITに詳しいメンバーや総務が兼任で一次対応を担っており、割り込み対応が本来業務を止めているからです。一方で、問い合わせが月に数件しかない、内容のほとんどが個別判断を要する、そもそも答えを文書化する時間が取れない——という状態なら、導入を急ぐ必要はありません。その場合は、まず問い合わせの記録とFAQの文書化という「前工程」から始めるのが、遠回りに見えて確実です。

    ### 導入の一歩目は、FAQ・マニュアルの棚卸しから

    ここまでの内容から、導入の初手はツール選定ではないことが分かります。順序は、①よくある問い合わせの上位20〜30件を洗い出す ②その答えをAIが読めるテキストとして整備・更新する ③対象範囲を絞って(たとえば社内のIT・総務の定型質問だけ)スモールスタートする ④問い合わせログを見てFAQを追記し、範囲を広げる——です。導入までの期間はナレッジの整備度でほぼ決まります。FAQが整っていればSaaS型ツールの設定自体は短期間で済みますが、整備から始める場合は棚卸しに相応の期間を見込んでください。なお、この具体的な進め方(各ステップの実務)は、別途手順記事として深掘り予定です。

    もう一つ、視点として持っておきたいのは、**AIヘルプデスクのために整えたナレッジは、問い合わせ対応の専用資産ではない**ということです。AIが読める形に整えたFAQ・マニュアル・業務文書は、資料作成・引き継ぎ・オンボーディングなど、他の業務を担うAIの共有脳としてそのまま使い回せます。問い合わせ自動化を単発のツール導入で終わらせず、社内ナレッジ基盤への入口と位置づけると、投資の回収先が一気に広がります。私たちが「AI社員」と呼ぶ働き方——複数のAIエージェントが同じナレッジベースを参照して部門業務を分担する形——も、この延長線上にあります。

    **「自社のナレッジは、AIヘルプデスクに耐えられる状態か」から確認したい方へ** — PolarisXは、社内ナレッジベースの構築と、それを参照して働く司令塔AI社員「Polaris AI」を提供しています。問い合わせ自動化を、ツール選定からではなくナレッジの棚卸しから一緒に設計します。無料相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へどうぞ。

    ## 用語の要点

    – **AIヘルプデスク**:社内外からの問い合わせの一次対応をAIが担う仕組み。受付→ナレッジ検索(RAG)→回答生成→エスカレーションの流れで動き、チャットボットはこの仕組みを構成する部品の一つ。
    – **費用相場(執筆時点の報告値)**:シナリオ型は月額数千円〜5万円程度、AI搭載型は月額10万〜50万円程度、生成AI・RAG型は月額15万〜50万円程度から。単一の相場はなく、金額より「ナレッジ整備支援まで含むか」で見る。
    – **成否の分かれ目**:AIの回答精度は参照するナレッジの質と量で決まる。導入前に「よくある問い合わせ上位20件の答えがAIから読めるテキストで存在するか」を確認し、なければツール選定よりナレッジの棚卸しが先。

    ## よくある質問

    **Q. AIヘルプデスクとは何ですか?どんな仕組みで動きますか?**
    社内外からの問い合わせの一次対応をAIが担う仕組みです。従業員・顧客からの質問を受け付け、FAQ・マニュアルなどの社内ナレッジをAIが検索し(RAG)、見つけた根拠をもとに回答を生成し、解決できない質問だけを担当者へ引き継ぎます。24時間365日応答でき、回答が担当者個人に依存しない点が人手の窓口との違いです。

    **Q. AIヘルプデスクとチャットボットは何が違いますか?**
    チャットボットは自動応答を行うツール(部品)で、AIヘルプデスクはそれを含む問い合わせ対応業務全体の仕組みです。AIヘルプデスクには、チャットボットのような応答部品に加えて、参照するナレッジの整備、有人への引き継ぎ(エスカレーション)、問い合わせログをもとにした運用改善までが含まれます。部品だけを置いて仕組みを作らない導入は形骸化しやすくなります。

    **Q. AIヘルプデスクを導入するとどんな効果がありますか?**
    定型問い合わせの一次対応の自動化による対応工数の削減、24時間365日対応による解決までの時間短縮、回答品質の均一化、問い合わせログの蓄積によるFAQ改善——の4つが代表的です。効果の大きさは定型質問の割合とナレッジの整備度に依存し、公開事例の削減率は各社の条件下での報告値のため、そのまま自社に当てはめず「どんな質問をAIに任せたか」を読み取るのが実務的です。

    **Q. AIヘルプデスクの費用相場はいくらですか?**
    執筆時点(2026年7月)の複数メディアの報告値を突き合わせると、シナリオ型で月額数千円〜5万円程度、AI搭載型(FAQ学習型)で月額10万〜50万円程度、生成AI・RAG型で月額15万〜50万円程度からが目安です。問い合わせ件数・設置チャネル数・従量課金・初期のナレッジ整備支援の有無で大きく変わるため、複数社の見積もりで「金額に何が含まれるか」を比べてください。

    **Q. AIヘルプデスク導入のデメリット・失敗パターンは何ですか?**
    最大の失敗パターンは、FAQ・マニュアルが未整備のまま導入し、誤答や「分かりません」が続いて使われなくなる形骸化です。AIの回答精度は参照するナレッジの質と量に依存するため、ツールの乗り換えでは解決しません。ほかに、エスカレーション設計の欠如によるたらい回し、個人情報・機密情報の扱いを決めずに参照範囲を広げてしまうセキュリティ上の問題が典型的なつまずきです。

    **Q. AIヘルプデスクはどんな企業・部署に向いていますか?**
    同じ質問が繰り返し届き、答えを文書化できる組織に向いています。部署では情シス・人事・総務・経理などの管理部門とカスタマーサポート、会社の規模では専任情シスのいない従業員30〜100名の企業も有力な候補です。逆に問い合わせが少量で内容が毎回異なる場合は、まず問い合わせの記録とFAQの文書化から始めるほうが効果的です。

    **問い合わせ対応の自動化を「自社に残る形」で進めたい方へ** — PolarisXは、①法人向けAIエージェントの開発 ②社内ナレッジベースの構築 ③AIコンサルティングサービスを提供する会社です。自社でも3部門・約20のAIエージェントを内製運用する当事者として、ナレッジの整備からAIヘルプデスクの定着までをご一緒します。ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。サービスの考え方は [polarisx.ltd](https://polarisx.ltd/) をご覧ください。

    ### この記事について

    PolarisX編集部(AI活用の実務者チーム)は、司令塔AI社員「Polaris AI」の開発と、自社AI社員組織(3部門・約20のAIエージェント)の運用実務に携わるメンバーで構成しています。社内ナレッジベースをAIの共有脳として日々運用する立場から、本記事は教科書的な解説に「ナレッジの整備度が成否を分ける」という実務の判断基準を加えてまとめました。内容のご指摘・ご相談は [contact@polarisx.ltd](mailto:contact@polarisx.ltd) へ。

    ## 参考文献

    – [「社内ヘルプデスク業務」の外部委託率が74%に急増 情報システム部門のヘルプデスク運用課題と生成AI活用の実態調査(キヤノンマーケティングジャパン株式会社・2025年)](https://prtimes.jp/main/html/rd/p/000001291.000013943.html)
    – [社内のOAヘルプデスク業務に『AIヘルプデスク』導入(アサヒグループホールディングス ニュースルーム・2017年)](https://www.asahigroup-holdings.com/newsroom/detail/20170713-0102.html)
    – [Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(Lewis et al., 2020)](https://arxiv.org/abs/2005.11401)
    – [RAG(検索拡張生成)とは何ですか?(AWS 公式ドキュメント)](https://aws.amazon.com/jp/what-is/retrieval-augmented-generation/)
    – [チャットボットの費用はいくら?初期費用・月額料金の相場から費用対効果の算出方法まで徹底解説(NTT東日本)](https://business.ntt-east.co.jp/content/cloudsolution/column-724.html)
    – [AIチャットボットの料金相場は?初期費用・月額費用・タイプ別比較を徹底解説【2026年版】(Tayori Blog・2026年)](https://tayori.com/blog/ai-chatbot-pricing/)